Código
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")
plot(datos$LIQUIDEZ_INMEDIATA, datos$ROA,
     xlab = "LIQUIDEZ_INMEDIATA",
     ylab = "ROA",
     main = "ROA en función de la liquidez",
     pch = 19)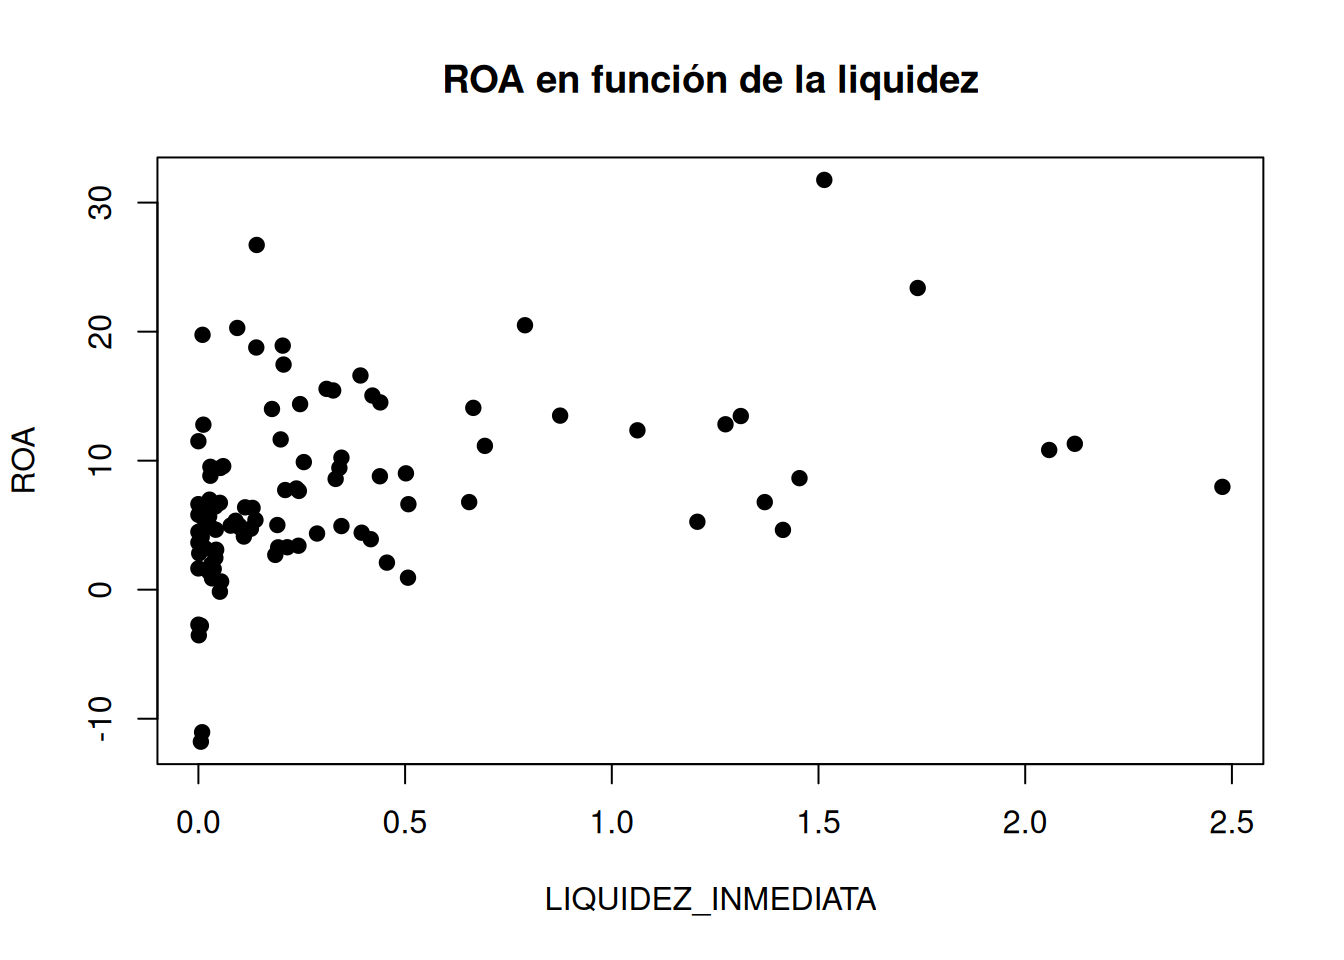
Al finalizar este capítulo, el estudiante será capaz de:
Uno de los supuestos del modelo clásico de regresión lineal es que la perturbación aleatoria presenta una varianza constante para todas las observaciones. Este supuesto se denomina homocedasticidad y puede expresarse como:
\[ Var(u_i \mid X)=\sigma^2, \qquad i=1,\ldots,n. \]
Esto significa que, independientemente de los valores que tomen las variables explicativas, la variabilidad de la perturbación alrededor de la relación media que establece el modelo es la misma para todas las observaciones.
Por el contrario, existe heterocedasticidad cuando la varianza de la perturbación no es constante entre las observaciones. En este caso:
\[ Var(u_i \mid X)=\sigma_i^2, \qquad \sigma_i^2\neq\sigma^2. \]
Por tanto, la diferencia fundamental entre ambos casos es que, bajo homocedasticidad, los errores presentan una dispersión aproximadamente constante, mientras que bajo heterocedasticidad dicha dispersión cambia en función de las características de las observaciones.
La heterocedasticidad adquiere especial importancia cuando se trabaja con datos transversales, es decir, cuando se observan distintas unidades económicas en un mismo periodo o en un periodo determinado. En estos casos, las unidades analizadas suelen presentar diferencias importantes entre sí.
En nuestro ejemplo, las empresas de la muestra pueden diferir considerablemente en términos de tamaño, liquidez, endeudamiento, número de empleados y otras características. Por ello, resulta razonable plantearse si la variabilidad de los factores no observados que afectan al ROA es realmente la misma para todas ellas.
Esta es una de las razones por las que la heterocedasticidad es un problema frecuente en modelos aplicados a empresas, hogares, países u otras unidades económicas observadas en sección cruzada.
Para ilustrar este concepto, consideremos el modelo utilizado para explicar la rentabilidad económica de las empresas:
\[ ROA_i=\beta_0+\beta_1LIQ_i+\beta_2LEV_i+\beta_3EMP_i+u_i. \] En este modelo, el término de perturbación \(u_i\) recoge todos aquellos factores que afectan al ROA de la empresa \(i\) y que no están incluidos explícitamente en el modelo. Si se cumple el supuesto de homocedasticidad, estamos suponiendo que la variabilidad de estos factores no observados es similar para todas las empresas. Es decir, una empresa pequeña y una empresa grande presentarían, en términos generales, una dispersión similar de sus errores alrededor del valor de ROA explicado por el modelo.
Sin embargo, esta hipótesis puede resultar poco realista en datos empresariales. Las empresas pueden presentar diferencias importantes en su tamaño, estructura financiera, actividad o capacidad de gestión. Por ejemplo, es posible que los errores de predicción sean relativamente pequeños para empresas de características similares, mientras que presenten una mayor dispersión entre empresas de mayor tamaño o con estructuras financieras más heterogéneas. En este caso, la varianza de la perturbación podría aumentar con alguna de las variables explicativas o con el propio nivel de la variable dependiente. Gráficamente, esto podría dar lugar a una nube de residuos cuya dispersión aumenta o disminuye a medida que aumenta el valor de una variable.
Como primera aproximación al análisis de la posible presencia de heterocedasticidad, se representa el ROA en función de la LIQUIDEZ_INMEDIATA. En la representación se observa que, para valores de liquidez próximos a cero, los valores del ROA presentan una dispersión relativamente reducida, mientras que, a medida que aumenta la liquidez, la dispersión de los valores del ROA parece incrementarse. Este patrón podría ser indicativo de una varianza no constante de la variable dependiente a lo largo de los distintos niveles de liquidez y, por tanto, constituye una primera evidencia visual compatible con la presencia de heterocedasticidad. No obstante, esta apreciación debe contrastarse posteriormente mediante procedimientos gráficos y contrastes estadísticos específicos.
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")
plot(datos$LIQUIDEZ_INMEDIATA, datos$ROA,
xlab = "LIQUIDEZ_INMEDIATA",
ylab = "ROA",
main = "ROA en función de la liquidez",
pch = 19)
En notación matricial, el supuesto de homocedasticidad puede expresarse como:
\[ Var(\mathbf{u}\mid X)=\sigma^2 I_n, \]
donde \(I_n\) es la matriz identidad de orden \(n\). Esta expresión implica que todos los términos de perturbación tienen la misma varianza y que, además, no existe correlación entre las perturbaciones.
Cuando existe heterocedasticidad, la matriz de varianzas y covarianzas deja de tener la forma \(\sigma^2 I_n\) y puede expresarse, de forma general, como:
\[ \sigma^2(u)= \begin{pmatrix} \sigma_1^2 & 0 & \cdots & 0\\ 0 & \sigma_2^2 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & \sigma_n^2 \end{pmatrix} \]
En principio cabe suponer que las \(n\) varianzas son distintas entre sí. El total de parámetros a estimar sería mayor que el número de observaciones que tenemos (\(n+k>n\)), por lo que el modelo no puede ser estimado. La idea fundamental para el tratamiento de la heterocedasticidad es buscar un patrón de comportamiento que relacione entre sí las varianzas y posibilitar la estimación del modelo.
La heterocedasticidad puede aparecer por diferentes motivos relacionados con la naturaleza de las variables, la forma en la que se han construido los datos o la especificación del modelo. Entre las causas más habituales pueden destacarse las siguientes.
En el modelo \(ROA_i=\beta_0+\beta_1LIQ_i+ \beta_2LEV_i+ \beta_3EMP_i+u_i\), es posible que la variabilidad de los factores no observados que afectan al ROA no sea la misma para todas las empresasas empresas, por ejemplo que las de mayor tamaño pueden presentar una mayor diversidad en sus resultados y, en consecuencia, una mayor dispersión de los residuos.
Uso de una forma funcional incorrecta. La heterocedasticidad también puede ser consecuencia de especificar incorrectamente la relación entre la variable dependiente y las variables explicativas. En particular, puede ocurrir que se suponga una relación lineal cuando la relación verdadera presenta una forma no lineal.
Uso de datos agregados. La heterocedasticidad puede aparecer cuando las observaciones utilizadas en el análisis son valores agregados correspondientes a grupos de distinto tamaño. En estos casos, la precisión o variabilidad de las observaciones puede depender del número de elementos que componen cada grupo. Por ejemplo, si se analiza la rentabilidad media de empresas de diferentes provincias o sectores, los grupos pueden presentar tamaños muy distintos. Una media calculada a partir de un número reducido de empresas puede presentar una variabilidad diferente de otra obtenida a partir de un grupo mucho más numeroso.
Omisión de variables relevantes. Otra posible causa de heterocedasticidad es la omisión de variables relevantes que afectan a la variable dependiente. Cuando una variable relevante no se incluye explícitamente en el modelo, su efecto queda incorporado a la perturbación aleatoria. Si, además, esta variable omitida está relacionada con alguna de las variables incluidas en el modelo, la varianza de la perturbación puede dejar de ser constante.
Para ilustrarlo, supongamos que el verdadero modelo que explica el ROA es:
\[ ROA_i=\beta_0+\beta_1LIQ_i+ \beta_2LEV_i+ \beta_3EMP_i+u_i, \]
pero se estima un modelo en el que se omite el tamaño de la empresa:
\[ ROA_i=\alpha_0+\alpha_1LIQ_i+ \alpha_2LEV_i+v_i. \]
La perturbación del modelo estimado recogerá ahora tanto los factores no observados \(u_i\) como el efecto de la variable omitida:
\[ v_i=u_i+\beta_3EMP_i. \]
Suponiendo que \(E(u_i)=0\), \(Var(u_i)=\sigma^2\) y que se cumplen las condiciones habituales de exogeneidad, se obtiene:
\[ \begin{aligned} Var(v_i) &=E[v_i^2]\\ &=E[(u_i+\beta_3EMP_i)^2]\\ &=\sigma^2+\beta_3^2EMP_i^2. \end{aligned} \]
Por tanto, la varianza de la perturbación dependerá del tamaño de la empresa y, en consecuencia, no será constante entre las observaciones.
En definitiva, aunque las causas de la heterocedasticidad pueden ser diferentes, en muchos casos la varianza no constante está relacionada con alguna característica de las observaciones, ya sea una variable incluida en el modelo o una variable que ha sido omitida. Por ello, resulta útil representar de forma general la varianza de la perturbación como:
\[ \sigma_i^2=\sigma^2 f(X_i), \]
donde \(\sigma^2\) representa un componente común de la varianza y \(f(X_i)\) recoge el comportamiento de la varianza asociado a la variable o variables que generan la heterocedasticidad.
Esta expresión permite entender que la heterocedasticidad no implica necesariamente que toda la estructura de la varianza sea desconocida. Una parte puede representarse mediante un componente constante, mientras que otra depende de determinadas características de las observaciones. Esta idea será especialmente relevante posteriormente al estudiar los procedimientos de estimación y las alternativas que permiten realizar inferencia cuando no se cumple el supuesto de homocedasticidad.
Bajo los supuestos del modelo de regresión lineal, los estimadores de mínimos cuadrados ordinarios (MCO) son lineales, insesgados y eficientes, es decir, presentan la menor varianza dentro de la clase de estimadores lineales e insesgados. Sin embargo, cuando se incumple el supuesto de homocedasticidad, manteniéndose el resto de hipótesis del modelo, estas propiedades se ven afectadas.
En concreto, las principales consecuencias de la heterocedasticidad son las siguientes:
Los estimadores MCO siguen siendo insesgados y consistentes, pero dejan de ser eficientes. La presencia de heterocedasticidad no introduce, por sí misma, un sesgo en los estimadores de los coeficientes. Sin embargo, los estimadores MCO ya no presentan la mínima varianza posible dentro de la clase de estimadores lineales e insesgados. Por tanto, aunque las estimaciones puntuales de los coeficientes sigan siendo válidas, existen otros estimadores que pueden proporcionar estimaciones más precisas.
La estimación habitual de la matriz de varianzas-covarianzas de los estimadores MCO deja de ser válida. Las expresiones utilizadas bajo el supuesto de homocedasticidad para calcular los errores estándar se basan en que la varianza de la perturbación es constante. Cuando este supuesto no se cumple, los errores estándar calculados mediante el procedimiento convencional pueden estar incorrectamente estimados.
La inferencia estadística puede verse afectada. Si los errores estándar no están correctamente estimados, los estadísticos utilizados en los contrastes de hipótesis, como los estadísticos \(t\) y \(F\), pueden no seguir las distribuciones teóricas que se les atribuyen bajo los supuestos habituales. En consecuencia, las decisiones sobre la significación individual de los coeficientes o sobre la significación global del modelo pueden ser incorrectas.
Los intervalos de confianza y los intervalos de predicción pueden ser incorrectos. Al depender estos intervalos de la estimación de la varianza de los estimadores y de la perturbación, una estimación incorrecta de dicha varianza puede conducir a intervalos demasiado amplios o demasiado estrechos. Por tanto, la incertidumbre asociada a las estimaciones y predicciones puede estar mal cuantificada.
MCO no tiene en cuenta que algunas observaciones contienen más información que otras. Cuando existe heterocedasticidad, las observaciones no presentan la misma variabilidad. Una observación asociada a una perturbación con varianza elevada proporciona, en términos relativos, menos información sobre la relación entre las variables que una observación cuya perturbación presenta una varianza menor. Sin embargo, MCO trata todas las observaciones de la misma manera al minimizar la suma de cuadrados de los residuos. Esta es una de las razones por las que, cuando se conoce la estructura de la heterocedasticidad, pueden utilizarse métodos de estimación como los mínimos cuadrados generalizados (MCG), que permiten asignar un peso diferente a las observaciones en función de su varianza.
En resumen, la heterocedasticidad no hace que los estimadores MCO dejen de ser insesgados, pero sí afecta a su eficiencia y, especialmente, a la correcta estimación de sus errores estándar. Por ello, el principal problema práctico de la heterocedasticidad no se encuentra necesariamente en los valores estimados de los coeficientes, sino en la inferencia estadística que se realiza a partir de ellos.
En el contexto de Finanzas y Contabilidad, esto es especialmente importante. Por ejemplo, si se estima un modelo para explicar el ROA de un conjunto de empresas y la variabilidad del ROA es diferente entre empresas, los coeficientes MCO pueden seguir siendo insesgados, pero los errores estándar convencionales pueden ser incorrectos. Como consecuencia, podríamos concluir que una variable como la LIQUIDEZ_INMEDIATA o el ENDEUDAMIENTO es estadísticamente significativa cuando realmente no lo es, o no detectar una relación que sí resulta significativa. Por este motivo, una vez detectada la heterocedasticidad, será necesario utilizar procedimientos de inferencia o métodos de estimación que tengan en cuenta esta circunstancia.
La detección de la heterocedasticidad constituye una tarea especialmente importante, ya que la perturbación aleatoria del modelo no es directamente observable. Por ello, no podemos analizar de forma directa la varianza del término de error y debemos recurrir a los residuos estimados como aproximación.
Los procedimientos de detección pueden dividirse en dos grandes grupos:
En primer lugar, se estudiarán los métodos gráficos y, posteriormente, se presentarán los principales contrastes de heterocedasticidad.
Los métodos gráficos proporcionan una primera aproximación intuitiva a la existencia de heterocedasticidad. Su principal utilidad consiste en analizar si la dispersión de los residuos cambia sistemáticamente a medida que varía una determinada variable o a lo largo de las observaciones.
Es importante señalar que un gráfico, por sí solo, no permite concluir formalmente que existe heterocedasticidad. La interpretación puede depender de la escala utilizada y, en ocasiones, el patrón observado puede resultar difícil de distinguir visualmente. Por este motivo, las conclusiones obtenidas mediante gráficos deben complementarse posteriormente con un contraste analítico.
Dentro de los procedimientos gráficos pueden distinguirse los siguientes.
Una primera posibilidad consiste en representar los residuos estimados \(e_i\) o sus cuadrados \(e_i^2\) frente al número de observación \(i\).
El objetivo es comprobar si la dispersión de los residuos parece mantenerse aproximadamente constante a lo largo de la muestra. Si se observan zonas en las que los residuos presentan una dispersión claramente diferente de otras, puede existir evidencia gráfica de heterocedasticidad.
Por ejemplo, si al avanzar en las observaciones los residuos pasan de estar muy concentrados alrededor de cero a presentar una dispersión cada vez mayor, podría aparecer un patrón similar a un abanico, lo que constituiría una primera indicación de que la varianza de la perturbación no es constante.
plot(residuals(modelo_roa),
     type = "p",
     xlab = "Observación",
     ylab = "Residuos",
     main = "Residuos del modelo de ROA")
abline(h = 0, lty = 2)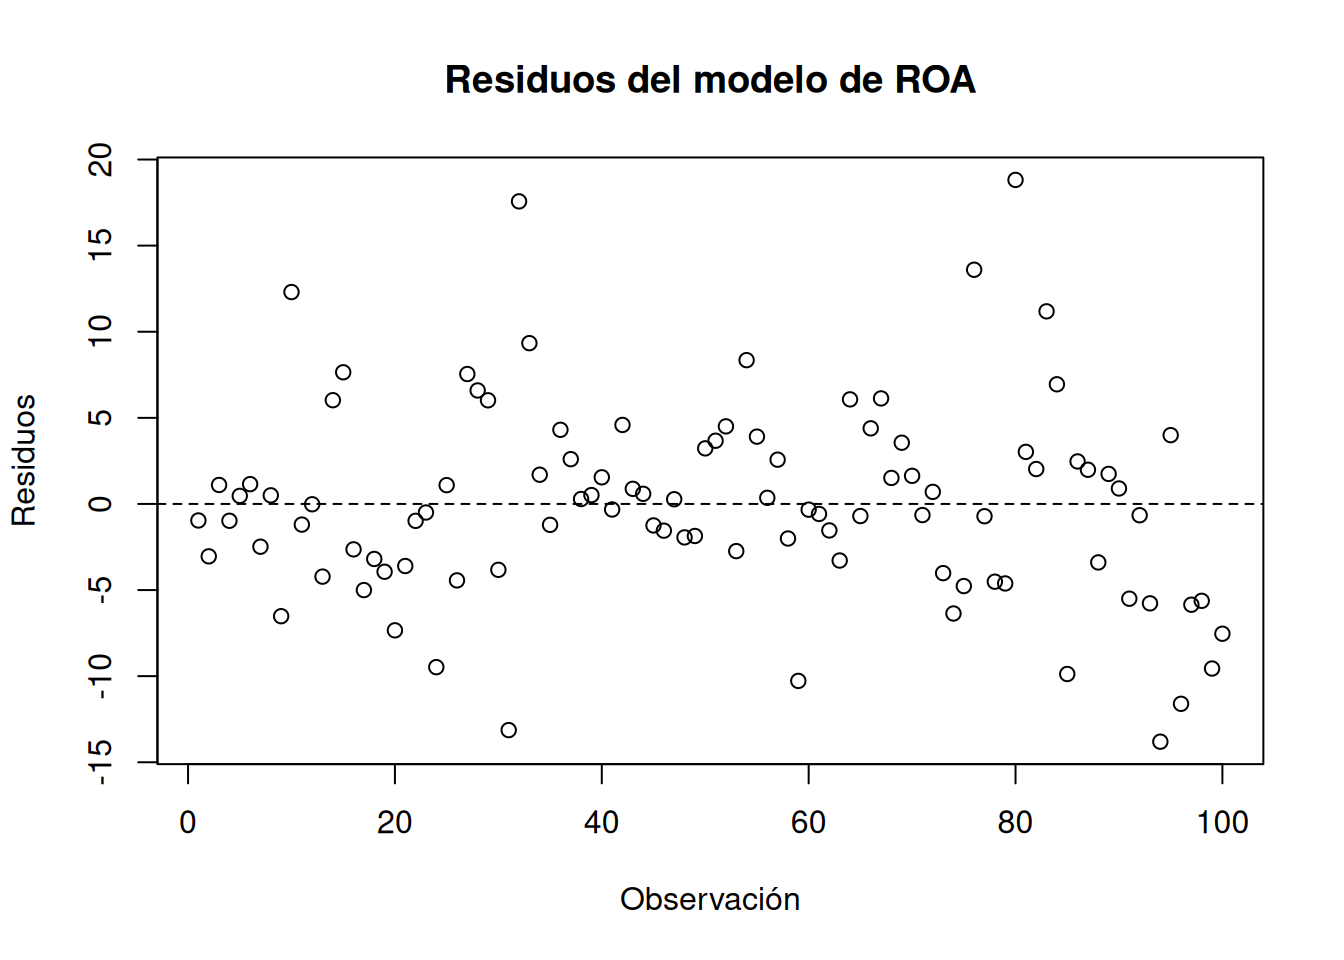
Y, el grafico de los residuos al cuadrado:
plot(residuals(modelo_roa)^2,
     type = "p",
     xlab = "Observación",
     ylab = "Residuos al cuadrado",
     main = "Residuos al cuadrado del modelo de ROA")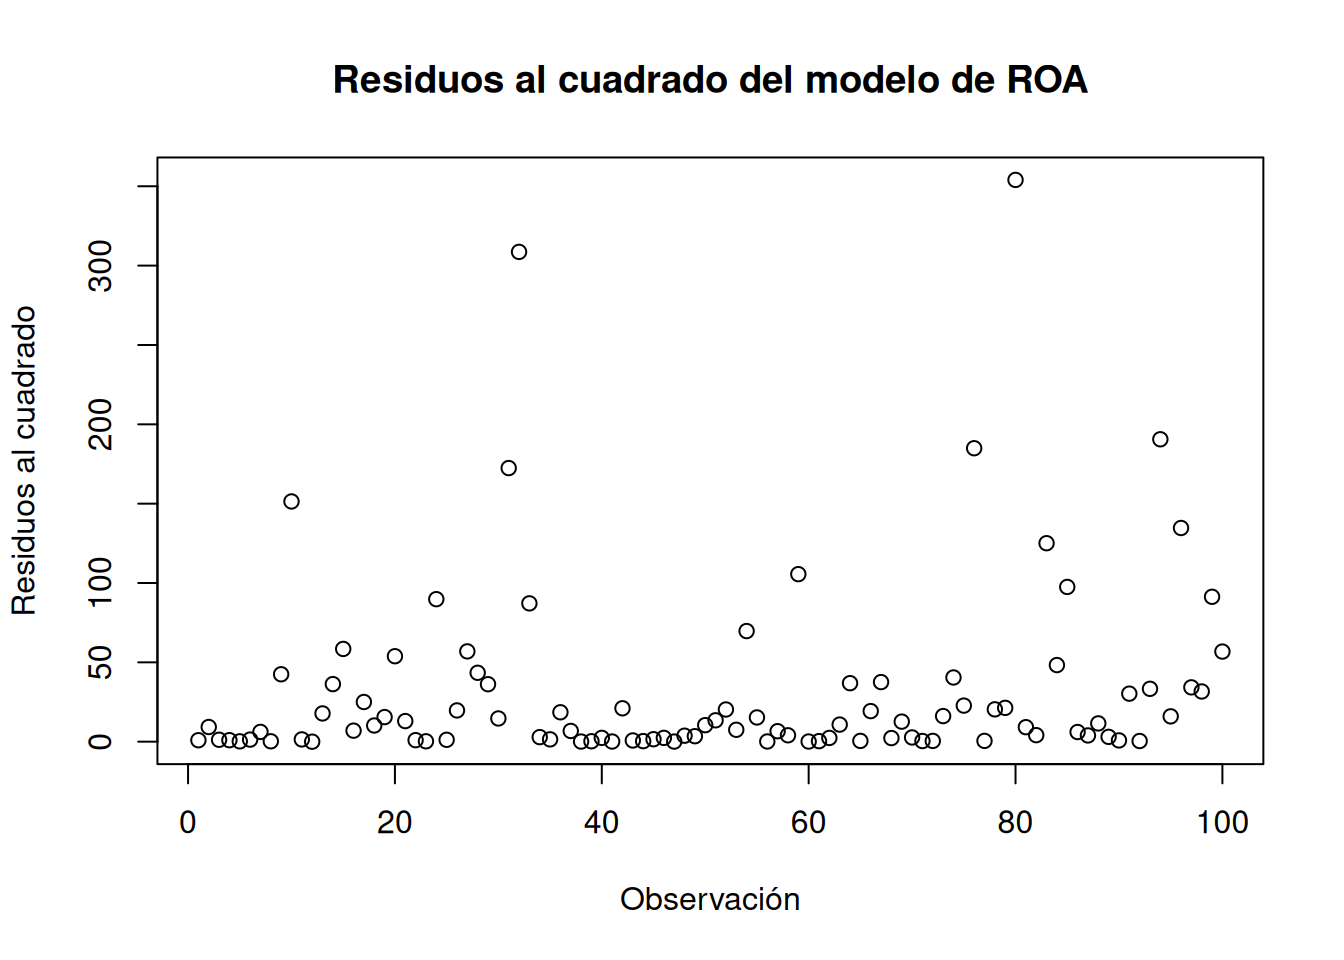
Una herramienta especialmente útil consiste en representar los residuos estimados, o sus cuadrados, frente a cada una de las variables explicativas del modelo. Esta representación permite analizar no solo si existe heterocedasticidad, sino también obtener una primera indicación sobre qué variable puede estar relacionada con el cambio en la varianza de los residuos.
Por ejemplo, consideremos el modelo utilizado para explicar la rentabilidad empresarial:
\[ ROA_i=\beta_0+\beta_1LIQ_i+ \beta_2LEV_i+ \beta_3EMP_i+u_i. \] Podemos representar los residuos frente a la variable LIQUIDEZ_INMEDIATA. Si la dispersión de los residuos permanece aproximadamente constante para todos los niveles de liquidez, no se apreciaría un patrón claro de heterocedasticidad. Por el contrario, si la dispersión aumenta conforme aumenta la liquidez, podría existir una relación entre la varianza de la perturbación y esta variable.
plot(datos$LIQUIDEZ_INMEDIATA,
     residuals(modelo_roa),
     xlab = "LIQUIDEZ_INMEDIATA",
     ylab = "Residuos",
     main = "Residuos frente a LIQUIDEZ_INMEDIATA")
abline(h = 0, lty = 2)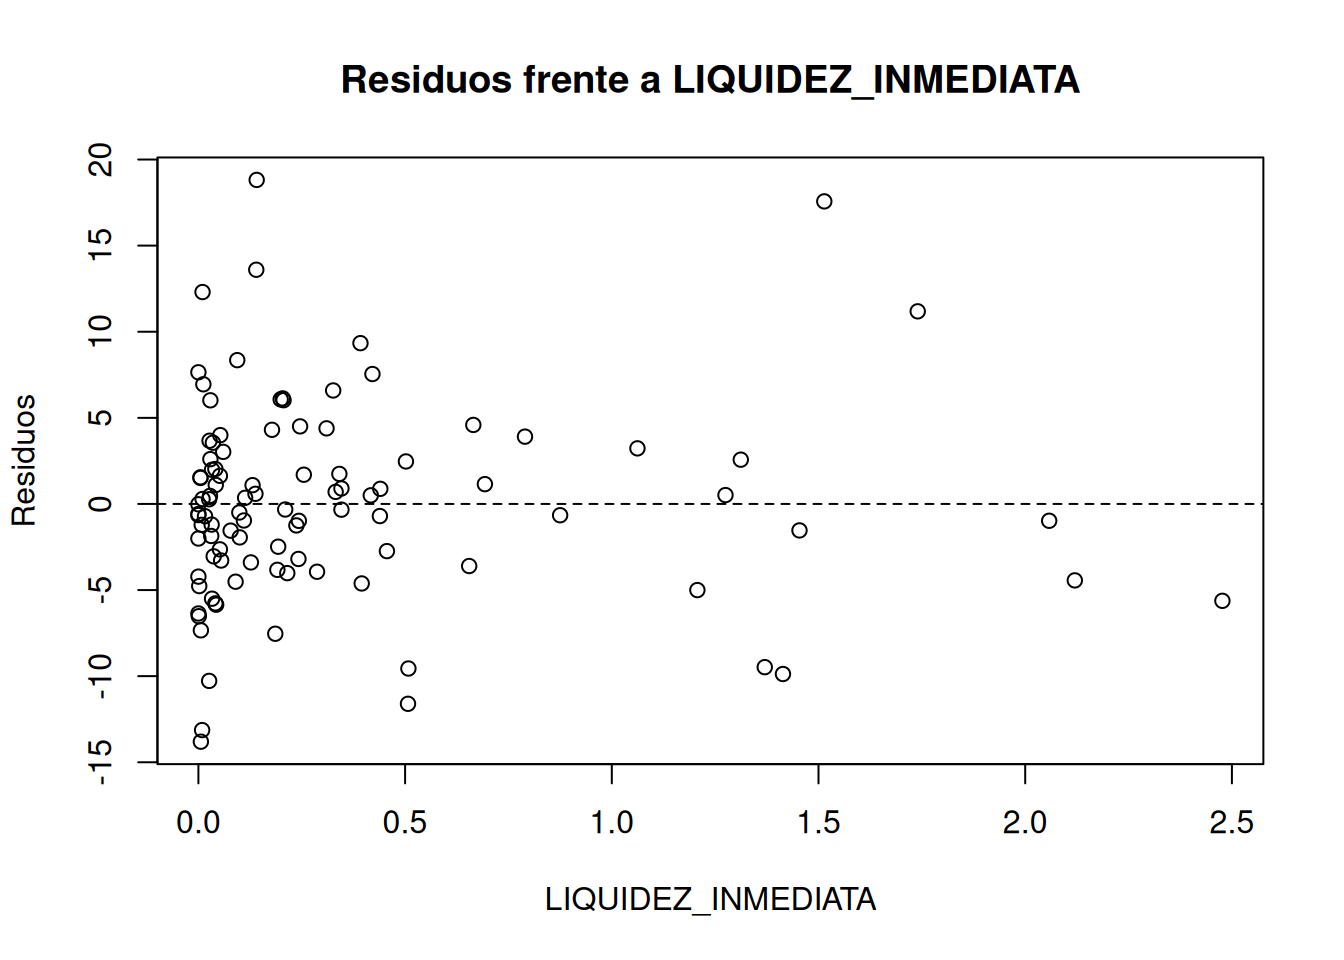
El mismo procedimiento puede realizarse frente a ENDEUDAMIENTO y EMPLEADOS, permitiendo comparar visualmente si la variabilidad de los residuos parece depender de alguna de las variables explicativas.
plot(datos$ENDEUDAMIENTO,
     residuals(modelo_roa),
     xlab = "ENDEUDAMIENTO",
     ylab = "Residuos",
     main = "Residuos frente a ENDEUDAMIENTO")
abline(h = 0, lty = 2)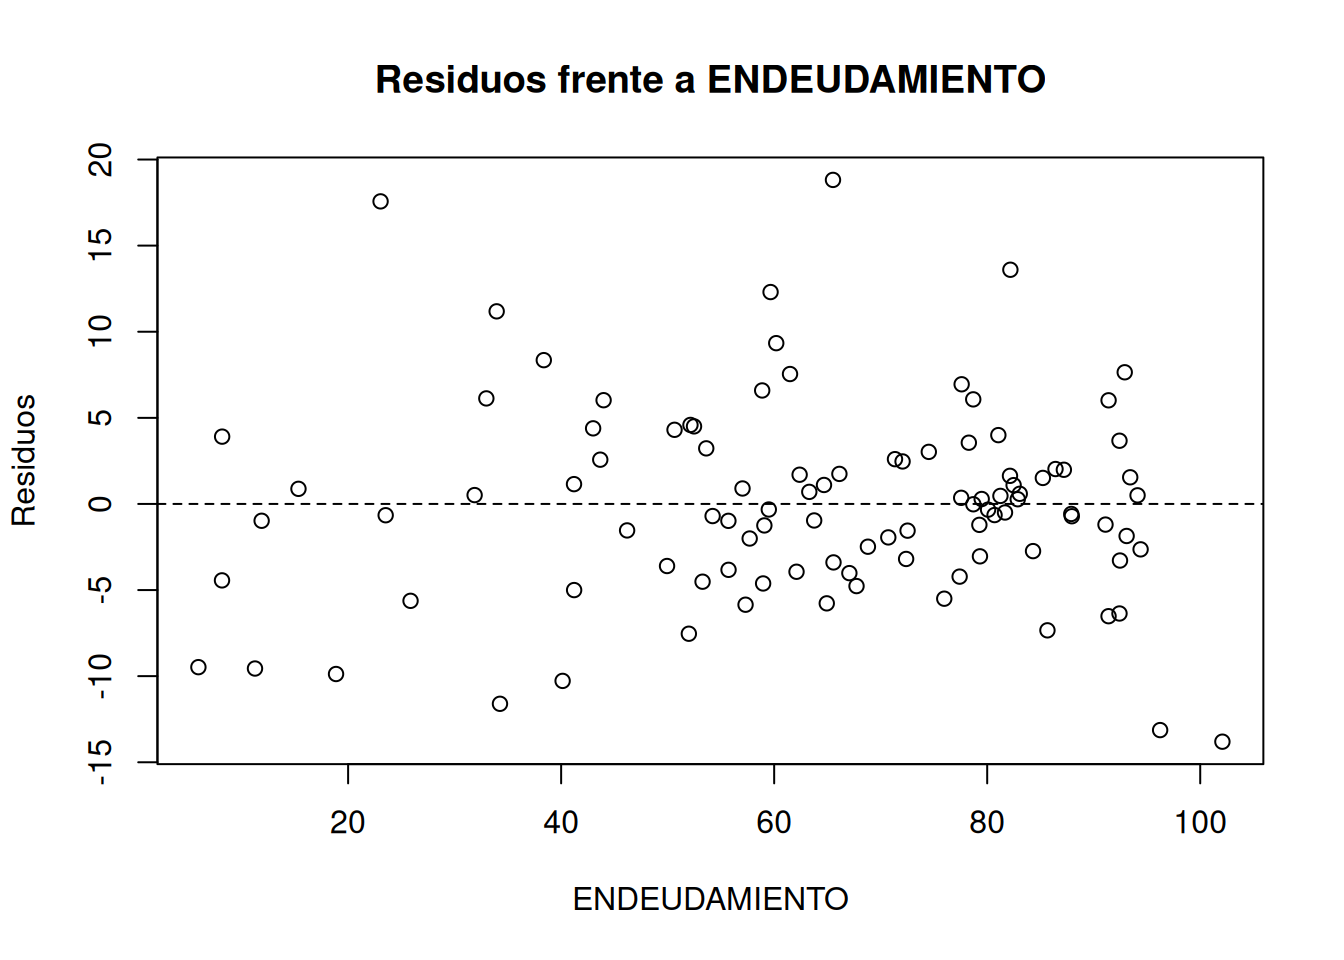
plot(datos$EMPLEADOS,
     residuals(modelo_roa),
     xlab = "EMPLEADOS",
     ylab = "Residuos",
     main = "Residuos frente a EMPLEADOS")
abline(h = 0, lty = 2)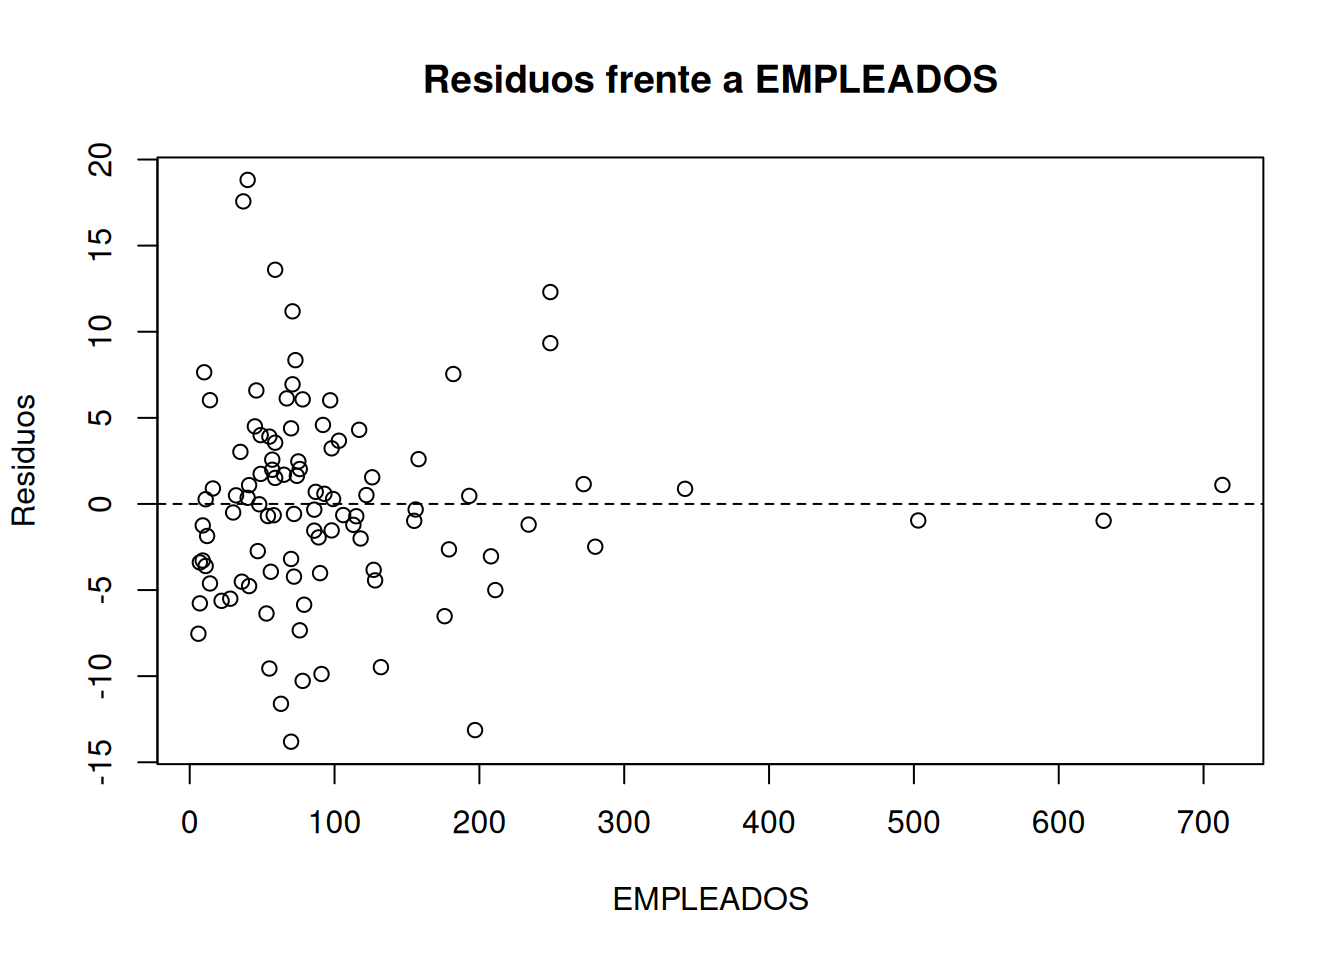
Al analizar estos gráficos, no debemos centrarnos únicamente en si los residuos están próximos o alejados de cero. Lo que interesa fundamentalmente es comprobar si la amplitud de la nube de puntos cambia sistemáticamente. Así, podemos encontrar diferentes situaciones:
No obstante, los métodos gráficos presentan una limitación importante: la decisión sobre la existencia de heterocedasticidad puede ser subjetiva. Dos investigadores podrían interpretar de manera diferente un mismo gráfico. Por ello, la evidencia gráfica debe considerarse como un diagnóstico inicial y debe complementarse con contrastes estadísticos formales, que permitirán determinar si existen evidencias suficientes para rechazar la hipótesis de homocedasticidad.
Los métodos gráficos permiten obtener una primera aproximación a la posible existencia de heteroscedasticidad, pero su interpretación es necesariamente subjetiva. Por ello, es necesario complementar el análisis gráfico con contrastes estadísticos formales. En todos los contrastes que se presentan a continuación, la hipótesis nula parte de la existencia de homoscedasticidad:
\[ H_0:\operatorname{Var}(u_i)=\sigma^2 \]
frente a una hipótesis alternativa de heteroscedasticidad:
\[ H_1:\operatorname{Var}(u_i)\neq\sigma^2. \]
La diferencia entre los distintos contrastes radica fundamentalmente en la forma que se supone que puede adoptar la heteroscedasticidad. Algunos contrastes imponen una estructura concreta sobre la varianza, mientras que otros permiten una alternativa más general.
Una idea común a varios de estos procedimientos es utilizar los residuos del modelo original para analizar si su variabilidad puede explicarse mediante las variables explicativas. Si los residuos presentan una relación sistemática con determinadas variables, ello constituye evidencia a favor de la existencia de heteroscedasticidad.
En este tema se estudiarán cuatro procedimientos:
En todos los casos, la regla general de decisión será la misma: si el p-valor es inferior al nivel de significación elegido, se rechaza la hipótesis nula de homoscedasticidad y se concluye que existe evidencia de heteroscedasticidad.
Permite analizar situaciones en las que se sospecha que la varianza de las perturbaciones cambia de forma monótona con respecto a una variable explicativa determinada. Por tanto, resulta especialmente apropiado cuando los gráficos sugieren que la dispersión de los residuos aumenta o disminuye conforme aumenta una determinada variable.
Por ejemplo, en el modelo de rentabilidad empresarial:
\[ ROA_i=\beta_0+\beta_1LIQ_i+ \beta_2LEV_i+ \beta_3EMP_i+u_i, \]
podríamos sospechar que la variabilidad del ROA aumenta con la LIQUIDEZ_INMEDIATA. El test de Goldfeld-Quandt permite contrastar formalmente esta posibilidad.
El procedimiento consta de las siguientes etapas:
\[ F_{exp}=\frac{SCR_2}{SCR_1}. \]
Si la varianza es mayor en el segundo grupo, el estadístico tomará valores elevados. Bajo la hipótesis nula, el estadístico sigue una distribución \(F\) con los grados de libertad correspondientes a los dos grupos. Una cuestión importante en este contraste es la elección de las observaciones centrales que deben eliminarse. No existe una única elección, aunque tradicionalmente se ha propuesto eliminar aproximadamente un tercio de la muestra. En cualquier caso, los dos grupos deben tener el mismo número de observaciones y disponer de suficientes grados de libertad para estimar el modelo.
En R, el contraste puede realizarse mediante la función gqtest() del paquete lmtest.
Constituye una alternativa más general, ya que no requiere especificar previamente una variable concreta como causante de la heteroscedasticidad ni asumir una forma funcional determinada para la varianza. La idea consiste en analizar si los residuos al cuadrado pueden explicarse mediante las variables explicativas del modelo, sus cuadrados y sus productos cruzados. Para el modelo:
\[ ROA_i=\beta_0+\beta_1LIQ_i+ \beta_2LEV_i+u_i, \]
la regresión auxiliar incluiría, de forma simplificada, términos como:
\[ \hat e_i^2= \alpha_0+\alpha_1LIQ_i+ \alpha_2LEV_i+ \alpha_3LIQ_i^2+ \alpha_4LEV_i^2+ \alpha_5LIQ_iLEV_i+v_i. \]
El contraste parte de la hipótesis:
\[ H_0:\text{homoscedasticidad} \]
frente a:
\[ H_1:\text{heteroscedasticidad}. \]
El estadístico utilizado es:
\[ LM=nR^2_{aux}, \]
que, bajo la hipótesis nula, sigue asintóticamente una distribución \(\chi^2\) con los grados de libertad correspondientes al número de restricciones de la regresión auxiliar.
En R, el test de White puede realizarse mediante la función bptest() del paquete lmtest, utilizando la opción studentize = FALSE:
bptest(modelo_roa, studentize = FALSE)
    Breusch-Pagan test

data:  modelo_roa
BP = 3.735, df = 2, p-value = 0.1545
El resultado proporciona el estadístico del contraste y su p-valor.
Por tanto, la interpretación es directa:
p-value < α, se rechaza \(H_0\) y existe evidencia de heteroscedasticidad.p-value ≥ α, no se rechaza \(H_0\) y no se dispone de evidencia suficiente para afirmar que existe heteroscedasticidad.La principal ventaja del test de White es su flexibilidad, ya que no es necesario establecer previamente cuál es la variable que provoca el cambio en la varianza ni cuál es la forma funcional concreta de dicha relación. Sin embargo, esta misma generalidad constituye también una limitación: si se rechaza la hipótesis nula, el contraste indica que existe evidencia de heteroscedasticidad, pero no identifica por sí mismo cuál es su causa ni proporciona necesariamente una forma concreta para modelar la varianza.
Parte de una hipótesis alternativa más específica que la de White. En este caso se supone que la varianza de las perturbaciones puede explicarse mediante una relación lineal con un conjunto de variables. En términos generales, se supone que:
\[ \sigma_i^2= \alpha_1+\alpha_2Z_{2i}+\cdots+\alpha_kZ_{ki}. \]
Las variables \(Z\) pueden coincidir con las variables explicativas del modelo original o con un subconjunto de ellas.
El procedimiento se basa en los siguientes pasos:
En R, el contraste puede realizarse directamente mediante:
bptest(modelo_roa)
    studentized Breusch-Pagan test

data:  modelo_roa
BP = 2.2693, df = 2, p-value = 0.3215
En este caso, las variables explicativas del modelo modelo_roa se utilizan para analizar si existe una relación sistemática entre ellas y la varianza de las perturbaciones.
Si queremos especificar explícitamente las variables que consideramos relacionadas con la heteroscedasticidad, podemos utilizar:
bptest(modelo_roa,
       varformula = ~ datos$LIQUIDEZ_INMEDIATA + datos$ENDEUDAMIENTO + datos$EMPLEADOS)
    studentized Breusch-Pagan test

data:  modelo_roa
BP = 3.0002, df = 3, p-value = 0.3916
Esto resulta especialmente útil en el ejemplo del ROA porque permite plantear directamente la hipótesis de que la variabilidad de la rentabilidad empresarial puede depender de variables como la liquidez, el endeudamiento o el tamaño de la empresa, aproximado mediante el número de empleados.
La interpretación se realiza nuevamente mediante el p-valor. Si este es inferior al nivel de significación elegido, se rechaza la hipótesis nula de homoscedasticidad.
Una diferencia importante respecto al test de White es, por tanto, que Breusch-Pagan plantea una estructura más concreta para la varianza, mientras que White permite una especificación mucho más general mediante cuadrados y productos cruzados de las variables explicativas.
El método de Glejser presenta un planteamiento diferente. Su objetivo no es únicamente detectar la existencia de heteroscedasticidad, sino también obtener información sobre la posible forma funcional de la varianza. El procedimiento parte de los residuos del modelo original y analiza si su valor absoluto puede explicarse mediante una variable que se sospecha que está relacionada con la heteroscedasticidad.
La regresión auxiliar adopta la forma:
\[ |\hat e_i|=\alpha+\beta X_i^h+v_i, \]
donde \(X_i\) es la variable que se considera potencialmente responsable de la heteroscedasticidad y \(h\) puede adoptar diferentes valores. Entre las especificaciones más habituales se encuentran:
\[ h\in{-2,-1,-1/2,1/2,1,2}. \]
En cada una de estas regresiones se analiza la significación individual del coeficiente asociado a la variable transformada.
Si el coeficiente no resulta significativo, no se encuentra evidencia de que esa transformación de la variable explique sistemáticamente la magnitud de los residuos.
Por el contrario, si el coeficiente resulta significativo, existe evidencia de que la magnitud de los residuos depende de dicha variable y, por tanto, de que puede existir heteroscedasticidad.
Si varias especificaciones resultan significativas, puede compararse su capacidad explicativa, por ejemplo mediante el \(R^2\), para determinar cuál proporciona un mejor ajuste de la magnitud de los residuos.
Es importante señalar que Glejser no constituye un contraste de hipótesis de heteroscedasticidad en el mismo sentido que Breusch-Pagan o White. Su conclusión se basa en contrastes de significación de los parámetros de las regresiones auxiliares. Su interés reside en que, además de proporcionar evidencia sobre la existencia de heteroscedasticidad, puede aportar información sobre la forma que podría adoptar la varianza.
Como se ha señalado anteriormente, la presencia de heteroscedasticidad no impide que los estimadores de mínimos cuadrados ordinarios (MCO) sean lineales, insesgados y consistentes, pero sí hace que dejen de ser eficientes. Además, las expresiones habituales utilizadas para estimar las varianzas de los estimadores dejan de ser válidas.
La razón es que los estimadores MCO no incorporan la información relativa a las diferentes varianzas de las perturbaciones. Por tanto, si conocemos, o podemos estimar, cómo varía la varianza del término de perturbación entre las distintas observaciones, podemos utilizar esta información para transformar el modelo y obtener un modelo con perturbaciones homoscedásticas.
Consideremos el modelo lineal general:
\[ y=X\beta+u \]
donde:
\[ E(u)=0 \]
y la matriz de varianzas y covarianzas de las perturbaciones es:
\[ Var(u)=E(uu^t)= \begin{pmatrix} \sigma_1^2 & 0 & \cdots & 0\\ 0 & \sigma_2^2 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & \sigma_n^2 \end{pmatrix}. \]
Esta expresión indica que las perturbaciones están incorrelacionadas, pero presentan varianzas diferentes entre observaciones.
Por comodidad, podemos expresar cada una de estas varianzas como:
\[ \sigma_i^2=\sigma^2w_i, \]
de manera que:
\[ Var(u)=\sigma^2\Omega, \]
donde:
\[ \Omega= \begin{pmatrix} w_1 & 0 & \cdots & 0\\ 0 & w_2 & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & w_n \end{pmatrix}. \]
El objetivo es encontrar una transformación que permita convertir esta matriz de varianzas y covarianzas en una matriz proporcional a la identidad.
Para ello, definimos la matriz diagonal:
\[ P^{-1}= \begin{pmatrix} \dfrac{1}{\sqrt{w_1}} & 0 & \cdots & 0\\ 0 & \dfrac{1}{\sqrt{w_2}} & \cdots & 0\\ \vdots & \vdots & \ddots & \vdots\\ 0 & 0 & \cdots & \dfrac{1}{\sqrt{w_n}} \end{pmatrix}. \]
Al multiplicar el modelo original por esta matriz obtenemos:
\[ P^{-1}y=P^{-1}X\beta+P^{-1}u. \]
Definiendo:
\[ y^*=P^{-1}y,\qquad X^*=P^{-1}X,\qquad u^*=P^{-1}u, \]
el modelo transformado queda:
\[ y^*=X^*\beta+u^*. \]
En términos de cada observación:
\[ Y_i^*=\frac{Y_i}{\sqrt{w_i}}, \qquad X_{ji}^*=\frac{X_{ji}}{\sqrt{w_i}}, \qquad u_i^*=\frac{u_i}{\sqrt{w_i}}. \]
La transformación consigue que:
\[ E(u_i^*)=0 \]
y:
\[ Var(u_i^*)=\frac{1}{w_i}Var(u_i)=\frac{1}{w_i}\sigma^2w_i=\sigma^2. \]
Por tanto, las perturbaciones del modelo transformado presentan una varianza constante. Además, como las perturbaciones originales estaban incorrelacionadas, las perturbaciones transformadas también lo están.
En consecuencia, el modelo transformado presenta perturbaciones esféricas y podemos aplicar MCO sobre las variables transformadas.
La transformación anterior permite interpretar el procedimiento como un método de mínimos cuadrados ponderados (MCP).
La idea es sencilla: las observaciones no tienen todas la misma fiabilidad cuando la varianza de la perturbación es diferente entre ellas. Por ello, se asigna a cada observación un peso inversamente relacionado con la varianza de su perturbación.
En particular, si:
\[ Var(u_i)=\sigma^2w_i, \]
el peso utilizado en la transformación es:
\[ \frac{1}{w_i}. \]
Así, las observaciones asociadas a una mayor varianza reciben un menor peso, mientras que aquellas con una menor varianza reciben un mayor peso.
Esto resulta intuitivamente razonable: una observación cuyo término de perturbación presenta una elevada variabilidad contiene más incertidumbre y, por tanto, debe tener una menor influencia en la estimación de los parámetros.
En la práctica, normalmente no conocemos los valores \(w_i\) y, por tanto, tampoco conocemos exactamente la matriz de varianzas y covarianzas de las perturbaciones.
Por este motivo, es necesario estimar previamente la estructura de la heteroscedasticidad.
Los métodos gráficos y, especialmente, los contrastes analizados anteriormente pueden proporcionar información sobre la variable que está relacionada con la varianza de las perturbaciones. El procedimiento general consiste entonces en:
Este procedimiento recibe el nombre de mínimos cuadrados generalizados factibles (MCGF), ya que la matriz de varianzas y covarianzas desconocida se sustituye por una estimación de la misma.
Una alternativa a especificar el esquema concreto de la heteroscedasticidad consiste en mantener el modelo original estimado por MCO y utilizar errores estándar robustos.
Estimamos primero el modelo original:
modelo_roa <- lm(
  ROA ~ LIQUIDEZ_INMEDIATA + ENDEUDAMIENTO + EMPLEADOS,
  data = datos
)
A continuación, podemos obtener errores estándar robustos mediante las funciones vcovHC() y coeftest():
coeftest(
  modelo_roa,
  vcov = vcovHC(modelo_roa, type = "HC0")
)
t test of coefficients:

                     Estimate Std. Error t value  Pr(>|t|)
(Intercept)        18.4459978  3.3734817  5.4679 3.603e-07 ***
LIQUIDEZ_INMEDIATA -0.2677055  1.8651095 -0.1435 0.8861698
ENDEUDAMIENTO      -0.1562574  0.0417377 -3.7438 0.0003089 ***
EMPLEADOS          -0.0067096  0.0035829 -1.8727 0.0641580 .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
En este caso, los coeficientes estimados no cambian respecto a MCO. Lo que cambia es la estimación de su matriz de varianzas-covarianzas y, por tanto, los errores estándar, los estadísticos de contraste y los p-valores.
La diferencia entre ambos procedimientos es importante:
Por tanto, si se dispone de información suficiente para justificar el esquema de la varianza, los mínimos cuadrados ponderados pueden aprovechar esa información. Si no se conoce adecuadamente la estructura de la heteroscedasticidad, los errores estándar robustos proporcionan una alternativa más flexible para realizar inferencia válida.
\[precio_i=\beta_1+\beta_2nhab_i+\beta_3ant_i+u_i\] A partir de la siguiente información:
\[(X'X)^{-1}=\left( \begin{array}{ccc} 0.6657&-0.1424&-0.2994\\ -0.1424& 0.0610& -0.0145\\ - 0.2994& -0.0145& 0.4796\\ \end{array} \right); X'y=\left( \begin{array}{c} 2057.88\\ 5374.84\\ 1307.88\\ \end{array} \right);\sum_{i=1}^{n=10} precio_i^2=455.396,079\] Se pide:
Obtener los estimadores de los parámetros del modelo e interpretarlos.
Realice el contraste de significación global del modelo y construya la Tabla Anova.
Para profundizar en el estudio anterior, la inmobiliaria InmoGranada S.A. ha contactado con la consultora en la que usted trabaja y le ha propuesto ampliar el modelo a 50 observaciones y añadir como variable adicional la superficie medida en metros cuadrados (\(sup_i\)) ndo lugar al siguiente modelo estimado:
\[\hat{precio}\_i=23.5156+1.8161sup_i-4.3921nhab_i-24.8294ant_i; R^2=0.8441\]
Compare este modelo con el anterior en terminos de bondad del ajuste.
Sospechan que la inclusión de la variable superficie en el modelo ha generado que la varianza de las perturbaciones del modelo no sea constante. Para analizarlo, ordenan los datos de menor a mayor en función de la variable superficie, eliminan 18 observaciones centrales y realizan una regresión para cada una de las submuestras resultantes, obteniendo los siguientes resultados:
\[i=1-16: \hat{precio}=41.1831+1.1278superficie-0.3728nhab-4.765ant; R^2=0.4266;SCT=6193.02\] \[i=35-50: \hat{precio}=129.8725+1.2084superficie-9.99nhab-36.8128ant; R^2=0.6237;SCT=16613\] Realice el contraste necesario y obtenga las conclusiones al 95% de confianza.