```{r}
#| include: false
library(readxl)
library(dplyr)
library(ggplot2)
library(car)
library(multiColl)
```
# Colinealidad
::: {.callout-important title="Objetivos de aprendizaje"}
Al finalizar este capítulo, el estudiante será capaz de:
- Comprender qué es la multicolinealidad y distinguir entre multicolinealidad perfecta y aproximada.
- Explicar por qué la existencia de relaciones lineales entre las variables explicativas puede dificultar la estimación precisa de sus efectos individuales.
- Identificar las principales causas de la multicolinealidad en aplicaciones económicas, financieras y contables.
- Interpretar los principales indicadores de diagnóstico de la multicolinealidad evitando considerar sus valores como reglas de decisión automáticas.
- Aplicar en R diferentes procedimientos para detectar y analizar la multicolinealidad en modelos de regresión lineal.
- Analizar críticamente si la presencia de multicolinealidad constituye realmente un problema para el objetivo concreto del análisis, distinguiendo entre la capacidad predictiva del modelo y la precisión de la estimación de los efectos individuales.
:::
## Concepto, causas y consecuencias
La multicolinealidad hace referencia a la existencia de una relación lineal entre las variables explicativas de un modelo de regresión. En otras palabras, se produce cuando una variable explicativa puede expresarse, al menos aproximadamente, como una combinación lineal de otras variables explicativas incluidas en el modelo.
Para entender este concepto, conviene distinguir entre colinealidad exacta y multicolinealidad aproximada.
- **Multicolinealidad exacta o perfecta:** se produce cuando existe una relación lineal exacta entre las variables explicativas. Por ejemplo, si en un modelo se incluyen las variables $X_2$, $X_3$ y $X_4$ y se verifica que $X_4 =2X_2+3X_3$ entonces existe una combinación lineal exacta entre las variables explicativas. Este hecho implica el incumplimiento de la hipótesis básica de rango completo por columnas, es decir, $rg(X) < k$, (para repasar el concepto de rango de una matriz, puede consultarse el @sec-apendice-matrices). En este caso, las columnas de la matriz $X$ son linealmente dependientes y, por tanto, la matriz $X^tX$ no es invertible. Como consecuencia, no es posible obtener el estimador MCO mediante la expresión $\hat{\beta}=(X'X)^{-1}X'y$.
Por tanto, la presencia de colinealidad exacta impide estimar el modelo por mínimos cuadrados ordinarios. En la práctica, esta situación suele estar asociada a errores en la especificación del modelo, como la inclusión simultánea de variables que contienen exactamente la misma información.
Un caso particular de colinealidad exacta es la denominada **trampa de las variables ficticias**, que aparece cuando se incluyen en el modelo tantas variables dicotómicas como categorías tiene una variable cualitativa junto con el término independiente. Por ejemplo, si una variable cualitativa tiene tres categorías y se incorporan tres variables dicotómicas, se verifica que:
$$D_1+D_2+D_3=1$$
por lo que una de las variables puede expresarse exactamente como combinación lineal de las demás y del término independiente. Para evitar este problema, cuando el modelo incorpora un término independiente, se utiliza habitualmente una categoría como referencia y se incluyen únicamente $m-1$ variables dicotómicas para una variable cualitativa con $m$ categorías.
- **Multicolinealidad aproximada:** se refiere a la existencia de una relación lineal fuerte *aproximada* entre dos o más variables independientes. En este caso, no se incumple la hipótesis básica de
rango completo $(rg(X) = k)$, por lo que se puede invertir $X^{t}X$ y obtener los estimadores por mínimos cuadrados ordinarios. Sin embargo, el determinante de $X^{t}X$ será muy próximo a cero,
haciendo que $(X^{t}X)^{-1}$ contenga valores muy altos.
Además de distinguir entre colinealidad exacta y multicolinealidad aproximada, la multicolinealidad puede clasificarse atendiendo a las variables que intervienen en la relación y al origen del problema.
**En función de las variables que la generan:**
- *Multicolinealidad aproximada no esencial:* se produce cuando una variable explicativa presenta una relación lineal elevada con el término independiente. Esta situación puede aparecer cuando una de las variables explicativas presenta una variabilidad muy reducida y sus valores son prácticamente constantes en la muestra.
- *Multicolinealidad aproximada esencial:* se produce cuando existe una relación lineal elevada entre dos o más variables explicativas, sin considerar el término independiente. En este caso, los regresores contienen información muy similar, lo que dificulta identificar de forma precisa el efecto individual de cada variable sobre la variable dependiente.
**En función del problema que la genera:**
- *Multicolinealidad errática:* Viene provocada por un problema numérico y es impredecible. Es decir esta relacionado con las caracteristicas de los datos (tipo de muestra, tamaño de la muestra, etc.). En este caso Se dice que la matriz $X'X$ esta mal condicionada.
- *Multicolinealidad sistemática:* Viene provocado por un problema estructural generado por una alta relación entre los regresores y se dice que es predecible.
### Causas de la colinealidad
La existencia de relaciones lineales elevadas entre las variables explicativas puede deberse a diferentes circunstancias relacionadas tanto con la naturaleza de las variables como con las características de la muestra. Entre las principales causas pueden destacarse las siguientes:
- **Relación causal entre variables explicativas:** Algunas variables presentan, por su propia naturaleza económica, una relación entre ellas, de manera que tienden a evolucionar conjuntamente. Cuando se incluyen simultáneamente en un modelo, esta relación puede generar un elevado grado de colinealidad.
*Ejemplo*: En el modelo utilizado para explicar el ROA de las empresas, las variables LIQUIDEZ_INMEDIATA y ENDEUDAMIENTO pueden presentar una relación elevada, ya que ambas recogen aspectos relacionados con la estructura financiera de la empresa.
- **Escasa variabilidad en las observaciones de las variables independientes:** Cuando una variable presenta valores muy similares para las distintas observaciones de la muestra, existe poca información para identificar con precisión su efecto sobre la variable dependiente. Esta situación puede favorecer problemas de colinealidad, especialmente en relación con el término independiente.
*Ejemplo*: Si se analiza una muestra de empresas pertenecientes a un mismo sector y todas presentan niveles de liquidez muy similares, la variable LIQUIDEZ_INMEDIATA tendrá una variabilidad reducida. En estas circunstancias, será más difícil estimar con precisión su efecto individual sobre el ROA.
- **Tamaño reducido de la muestra:** Cuando el número de observaciones es pequeño, las relaciones observadas entre las variables pueden estar condicionadas en mayor medida por las características particulares de la muestra. Esto puede generar correlaciones elevadas entre variables que no necesariamente presentan una relación tan fuerte en la población.
*Ejemplo*: Si se seleccionan únicamente unas pocas empresas de una población mucho más amplia, es posible que, por las características concretas de esas observaciones, LIQUIDEZ_INMEDIATA y ENDEUDAMIENTO presenten una correlación elevada. Al ampliar la muestra, dicha relación podría reducirse.s.
### Consecuencias de la colinealidad
Las consecuencias de la colinealidad dependen de si la relación lineal entre las variables explicativas es exacta o aproximada.
- En caso de **colinealidad exacta**, la matriz $X^tX$ no es invertible y, por tanto, no es posible obtener los estimadores MCO de forma individual mediante $\widehat{\beta}=(X^tX)^{-1}X^ty$. Esto significa que los coeficientes individuales de las variables explicativas no pueden identificarse de forma independiente. Sin embargo, sí pueden existir combinaciones lineales de los parámetros que sean estimables.
Por ejemplo, consideremos el modelo:
$$
Y_t=\beta_1+\beta_2X_{2t}+\beta_3X_{3t}+u_t
$$
y supongamos que existe una relación exacta entre las variables explicativas tal que $X_{2t}-X_{3t}=1$. En ese caso, podemos expresar $X_{2t}=1+X_{3t}$ y sustituirlo en el modelo:
$$
Y_t=\beta_1+\beta_2(1+X_{3t})+\beta_3X_{3t}+u_t,
$$
de donde:
$$
Y_t=(\beta_1+\beta_2)+(\beta_2+\beta_3)X_{3t}+u_t.
$$
Por tanto, aunque no sea posible identificar individualmente los tres parámetros del modelo original, sí pueden estimarse las combinaciones: $\beta_1+\beta_2$ y $\beta_2+\beta_3.$
En la práctica, R detectará esta situación al estimar el modelo y no proporcionará una estimación para alguno de los coeficientes afectados por la dependencia lineal exacta.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Supongamos que creamos una variable que denominados `Indice Financiero` que esta formada por la suma de las variables de endeudamiento y liquidez. Se observa que al estimar en R, el programa automáticamente detecta que existe colienalidad exacta y elimina esa variable de la estimación mostrando un NA:
```{r}
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")

# Crear una variable que es combinación lineal exacta
datos$INDICE_FINANCIERO <- datos$ENDEUDAMIENTO + datos$LIQUIDEZ_INMEDIATA

# Modelo con colinealidad exacta
modelo_exacta <- lm(
  ROA ~ ENDEUDAMIENTO + LIQUIDEZ_INMEDIATA + INDICE_FINANCIERO,
  data = datos
)

summary(modelo_exacta)
```
:::
- En caso de **colinealidad aproximada**, la matriz $X^tX$ sigue siendo invertible y, por tanto, los estimadores MCO pueden obtenerse. Sin embargo, cuando las variables explicativas presentan una relación lineal muy elevada, el determinante $|X'X|$ puede presentar valores muy pequeños pudiendo conducir a valores altos de $(X'X)^{-1}$. Dado que $Var(\widehat{\beta})=\sigma^2(X^tX)^{-1}$ la multicolinealidad puede tener las siguientes consecuencias:
- Aumento de las varianzas y de los errores estándar de los estimadores. Al aumentar la incertidumbre asociada a los coeficientes, sus intervalos de confianza serán más amplios.
- Menor significación individual de los coeficientes. Los errores estándar elevados pueden hacer que no se rechace la hipótesis nula de que un determinado coeficiente es igual a cero, incluso cuando las variables explicativas sean conjuntamente significativas.
- Dificultad para identificar los efectos individuales. Cuando dos variables explicativas contienen información muy similar, resulta difícil determinar qué parte del efecto sobre la variable dependiente corresponde a cada una de ellas.
- Mayor sensibilidad de los estimadores a cambios en los datos. Pequeñas modificaciones en la muestra, la incorporación o eliminación de observaciones o cambios en la especificación del modelo pueden producir variaciones importantes en los coeficientes estimados.
- Posibles signos y magnitudes poco estables de los coeficientes. En presencia de una elevada multicolinealidad, los coeficientes individuales pueden presentar valores o signos que resulten difíciles de interpretar económicamente y que sean sensibles a pequeñas modificaciones en la muestra.
Es importante señalar que la multicolinealidad aproximada no implica por sí misma que los estimadores MCO sean sesgados ni que el modelo deje de ser útil. Su principal consecuencia es una pérdida de precisión en la estimación de los efectos individuales. Por ello, puede observarse que un modelo presenta un buen ajuste global y un contraste F significativo, mientras que algunos o incluso todos los coeficientes individuales presentan una reducida significación estadística.
Por tanto, la existencia de multicolinealidad debe interpretarse teniendo en cuenta el objetivo del análisis. Si el interés se centra en la predicción, una elevada multicolinealidad puede no resultar necesariamente problemática si el modelo mantiene una buena capacidad predictiva. Sin embargo, si el objetivo principal es interpretar y contrastar los efectos individuales de las variables explicativas, la multicolinealidad puede constituir un problema importante.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Con el objeto de mostrar la diferencia entre la multicolinealidad exacta y la multicolinealidad aproximada, se genera una variable artificial denominada Índice Financiero, construida como la suma de las variables LIQUIDEZ_INMEDIATA y ENDEUDAMIENTO más una variable aleatoria que sigue una distribución Normal con media 0 y desviación típica igual a 1. De esta forma, la nueva variable presenta una relación lineal muy elevada con las variables LIQUIDEZ_INMEDIATA y ENDEUDAMIENTO, aunque dicha relación ya no es exacta.
En este caso, a diferencia del ejemplo anterior, el modelo sí puede estimarse, ya que no existe una relación lineal exacta entre las variables explicativas. Sin embargo, la elevada relación entre ellas genera un problema de multicolinealidad aproximada que afecta a la precisión de los estimadores. El efecto puede observarse en los resultados de la estimación: aunque el modelo puede presentar un buen ajuste, ninguno de los coeficientes de las variables explicativas resulta estadísticamente significativo. Únicamente el término independiente presenta significación estadística.
```{r}
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")

# Crear una variable que es combinación lineal aproximada
set.seed(123)

datos$INDICE_FINANCIERO_APROX <-
  datos$ENDEUDAMIENTO + datos$LIQUIDEZ_INMEDIATA +
  rnorm(nrow(datos), mean = 0, sd = 0.1)


# Modelo con colinealidad aproximada
modelo_aprox <- lm(
  ROA ~ ENDEUDAMIENTO + LIQUIDEZ_INMEDIATA + INDICE_FINANCIERO_APROX,
  data = datos
)

summary(modelo_aprox)
```
:::
## Procedimientos de detección de multicolinealidad
La multicolinealidad aproximada no puede identificarse mediante un único indicador. Por este motivo, resulta conveniente utilizar diferentes procedimientos que permitan detectar tanto la existencia de relaciones lineales entre las variables explicativas como su intensidad y posible origen. A continuación, se presentan los más utilizados habitualmente.
### Coeficientes de correlación muestral
Un primer procedimiento consiste en analizar los coeficientes de correlación muestral entre pares de variables explicativas. Una correlación elevada en valor absoluto constituye una primera señal de posible multicolinealidad.
Por ejemplo, si en el modelo utilizado para explicar el ROA las variables LIQUIDEZ_INMEDIATA y ENDEUDAMIENTO presentan una correlación elevada, existiría evidencia de que ambas variables contienen información similar y, por tanto, podría resultar difícil identificar sus efectos individuales.
Sin embargo, este procedimiento presenta una limitación importante: una matriz de correlaciones no permite detectar todas las formas de multicolinealidad. Una variable puede estar fuertemente relacionada con una combinación lineal de varias variables explicativas sin presentar una correlación especialmente elevada con ninguna de ellas por separado. Por tanto, la correlación por pares debe considerarse únicamente como un primer diagnóstico.
### Regresiones auxiliares
Un procedimiento más completo consiste en realizar una regresión auxiliar para cada variable explicativa, utilizándola como variable dependiente y empleando como explicativas el resto de los regresores del modelo.
Por ejemplo, consideremos el modelo utilizado para explicar el ROA de las empresas:
$$
ROA_i=\beta_1+\beta_2LIQUIDEZ\_INMEDIATA_i+\beta_3ENDEUDAMIENTO_i+\beta_4EMPLEADOS_i+u_i.
$$
Para analizar si existe una relación lineal elevada entre las variables explicativas, se estiman tres regresiones auxiliares.
En primer lugar, para analizar la posible colinealidad de LIQUIDEZ_INMEDIATA, se estima:
$$
LIQUIDEZ\_INMEDIATA_i=\gamma_1+\gamma_2ENDEUDAMIENTO_i+
\gamma_3EMPLEADOS_i+v_i.
$$
El coeficiente de determinación obtenido en esta regresión, $R^2_{LIQUIDEZ\_INMEDIATA}$, indica qué proporción de la variabilidad de LIQUIDEZ_INMEDIATA puede explicarse mediante ENDEUDAMIENTO y EMPLEADOS.
En segundo lugar, para analizar la posible colinealidad de ENDEUDAMIENTO, se estima:
$$
ENDEUDAMIENTO_i=\gamma_1+\gamma_2LIQUIDEZ\_INMEDIATA_i+
\gamma_3EMPLEADOS_i+v_i.
$$
En este caso, $R^2_{ENDEUDAMIENTO}$ mide qué proporción de la variabilidad de ENDEUDAMIENTO puede explicarse mediante las restantes variables explicativas.
Por último, para analizar la posible colinealidad de EMPLEADOS, se estima:
$$
EMPLEADOS_i=\gamma_1+\gamma_2LIQUIDEZ_i+
\gamma_3ENDEUDAMIENTO_i+v_i.
$$
El correspondiente $R^2_{EMPLEADOS}$ indica qué proporción de la variabilidad del número de empleados puede explicarse a partir de las otras dos variables. La lógica del procedimiento es sencilla: cuanto mayor sea el $R^2$ de una regresión auxiliar, mayor será la relación lineal entre la variable utilizada como dependiente y el resto de variables explicativas y, por tanto, mayor será el indicio de multicolinealidad.
### Factor de inflación de la varianza (FIV)
A partir de las regresiones auxiliares puede obtenerse el factor de inflación de la varianza (FIV). Para cada variable explicativa se define como:
$$
FIV(\widehat{\beta}_i)=\frac{1}{1-R_i^2},
\qquad i=2,\ldots,k,
$$
donde $R_i^2$ es el coeficiente de determinación obtenido al realizar la regresión auxiliar de la variable $X_i$ sobre el resto de variables explicativas.
El FIV indica en qué medida la varianza del estimador de un coeficiente se ve incrementada como consecuencia de la relación lineal existente entre su variable explicativa y las restantes variables del modelo.
Como referencia habitual, valores de:
$FIV < 4$: no suelen considerarse indicativos de un problema importante;
$4 \leq FIV < 10$: pueden indicar la existencia de multicolinealidad;
$FIV \geq 10$: constituyen una señal clara de posible multicolinealidad.
La relación entre el FIV y el $R_i^2$ permite interpretar estos valores. Si $FIV=10$, entonces $10=\frac{1}{1-R_i^2}$ lo que implica $R_i^2=0.90$. Es decir, el 90 % de la variabilidad de la variable explicativa considerada puede explicarse mediante las restantes variables del modelo. Estos valores deben interpretarse como reglas orientativas y no como puntos de corte absolutos. @OBrien2007 señala, precisamente, que el uso mecánico de un único umbral puede conducir a conclusiones inadecuadas.
El FIV presenta la ventaja de que permite identificar qué variables presentan mayores problemas de colinealidad, a diferencia de los indicadores globales del modelo. No obstante, el FIV es que no detecta la multicolinealidad de tipo no esencial. Además, no se puede calcular el FIV de variables
dicotómicas.
### Número de condición ($k(X)$)
Otro procedimiento consiste en analizar el número de condición de la matriz de variables explicativas. Este indicador permite evaluar el grado de dependencia lineal existente en el conjunto de regresores.
Se obtiene a partir de los autovalores de la matriz correspondiente. Si $\lambda_{\max}$ y $\lambda_{\min}$ representan, respectivamente, el mayor y el menor autovalor, el número de condición se define como:
$$k(X) = \sqrt{\frac{\lambda_{max}}{\lambda_{min}}} $$
Si $k(X)$ se sitúa entre 20 y 30, la colinealidad es probable; si supera
30, se considera grave (@Belsley). El número de condición si detecta la
multicolinealidad de tipo no esencial, pero el indicador es una medida
global para el modelo por lo que no detalla la variable causante.
#### Detección de la multicolinealidad no esencial {.unnumbered}
El número de condición puede utilizarse también para distinguir entre diferentes tipos de multicolinealidad. Para ello resulta útil comparar el número de condición calculado incluyendo el término independiente con el obtenido sin incluirlo.
La comparación permite detectar situaciones en las que una variable explicativa presenta una relación elevada con el término independiente como consecuencia de su escasa variabilidad. Este fenómeno se corresponde con la denominada multicolinealidad aproximada no esencial.
Cuando se detecta este problema, puede analizarse la variabilidad de las variables explicativas mediante, entre otros indicadores, el coeficiente de variación:
$$
CV=\frac{s_X}{\overline{X}},
$$
donde $s_X$ representa la desviación típica de la variable y $\overline{X}$ su media.
@salmeron2019diagnosis propone como referencia un valor de $CV$ inferior a 0.1002506 como indicativo de una variabilidad suficientemente reducida para que pueda aparecer una relación lineal fuerte con el término independiente.
En el caso de las variables dicotómicas, la situación debe analizarse de forma particular. Como estas variables únicamente pueden tomar los valores 0 y 1, su relación con el término independiente está estrechamente relacionada con la proporción de observaciones que toman el valor 1. Si una categoría es muy poco frecuente, la variable dicotómica presenta una variabilidad reducida y puede aparecer un problema de colinealidad no esencial.
Una posible solución cuando la colinealidad no esencial procede de una variable cuantitativa con una media elevada y poca variabilidad es centrar la variable, sustituyéndola por la diferencia respecto de su media:
$$
X_i^c=X_i-\overline{X}.
$$
El centrado no modifica la información contenida en la variable ni altera el ajuste del modelo, pero puede reducir la relación entre dicha variable y el término independiente y, por tanto, mejorar el condicionamiento numérico de la matriz de regresores.
### Paquete *multiColl*
Como se ha señalado, ninguno de los indicadores de multicolinealidad debe interpretarse de forma aislada. Cada uno proporciona información diferente sobre el problema: las correlaciones permiten detectar relaciones lineales entre pares de variables, las regresiones auxiliares y los FIV permiten identificar qué variables están más relacionadas con el resto, mientras que el número de condición ofrece una visión global de la dependencia lineal existente en el modelo.
Además, la combinación de estos indicadores permite distinguir entre diferentes situaciones. Por ejemplo, un FIV elevado puede indicar una relación lineal importante entre una variable y el resto de regresores, mientras que la comparación del número de condición con y sin término independiente puede aportar información adicional sobre la posible existencia de multicolinealidad no esencial. Por ello, el diagnóstico debe realizarse considerando conjuntamente los distintos indicadores y teniendo en cuenta la estructura concreta del modelo.
Para facilitar este diagnóstico conjunto puede utilizarse el paquete `multicoll` de R. Este paquete reúne diferentes indicadores que permiten analizar tanto la intensidad de la multicolinealidad como su posible origen, complementando los procedimientos presentados anteriormente.
Entre sus principales funciones se encuentran:
- *CN()*: Devuelve el número de condición de la matriz de diseño.
- *CNs()*: Calcula el número de condición considerando y sin
considerar el intercepto, y muestra el incremento porcentual. Esto
permite evaluar el efecto específico del intercepto sobre la
colinealidad.
- *CV()*: calcula el coeficiente de variación de una variable
cuantitativa.
- *CVs()*: calcula el coeficiente de variación de todas las variables
cuantitativas de la matriz, con la posibilidad de indicar variables
dummy que deben excluirse del cálculo.
- *VIF()*: Calcula los VIF para las variables cuantitativas.
- *multiCol()*: resume todas las medidas de diagnóstico disponibles
(CV, VIF, CN, ki, correlaciones, proporciones de dummies, etc.) y
puede incluir la representación gráfica de los coeficientes de
variación de cada variable explicativa en relación con su factor
inflactor de la varianza.
- *multiColLM()*: además de las medidas anteriores, proporciona las
estimaciones por MCO y analiza cómo cambian los coeficientes si se
perturban los datos, permitiendo evaluar la sensibilidad del modelo.
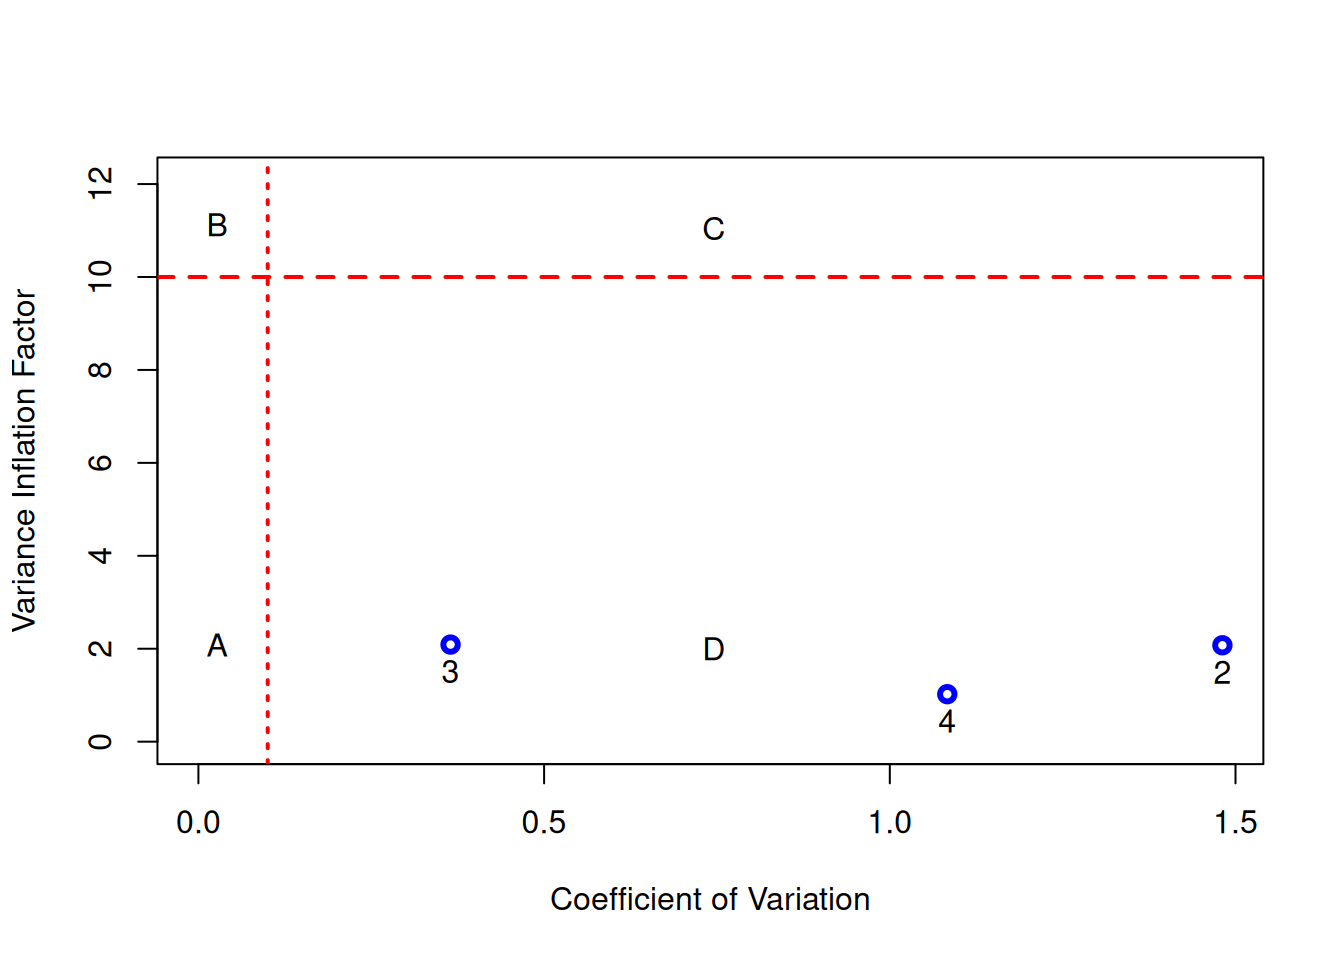
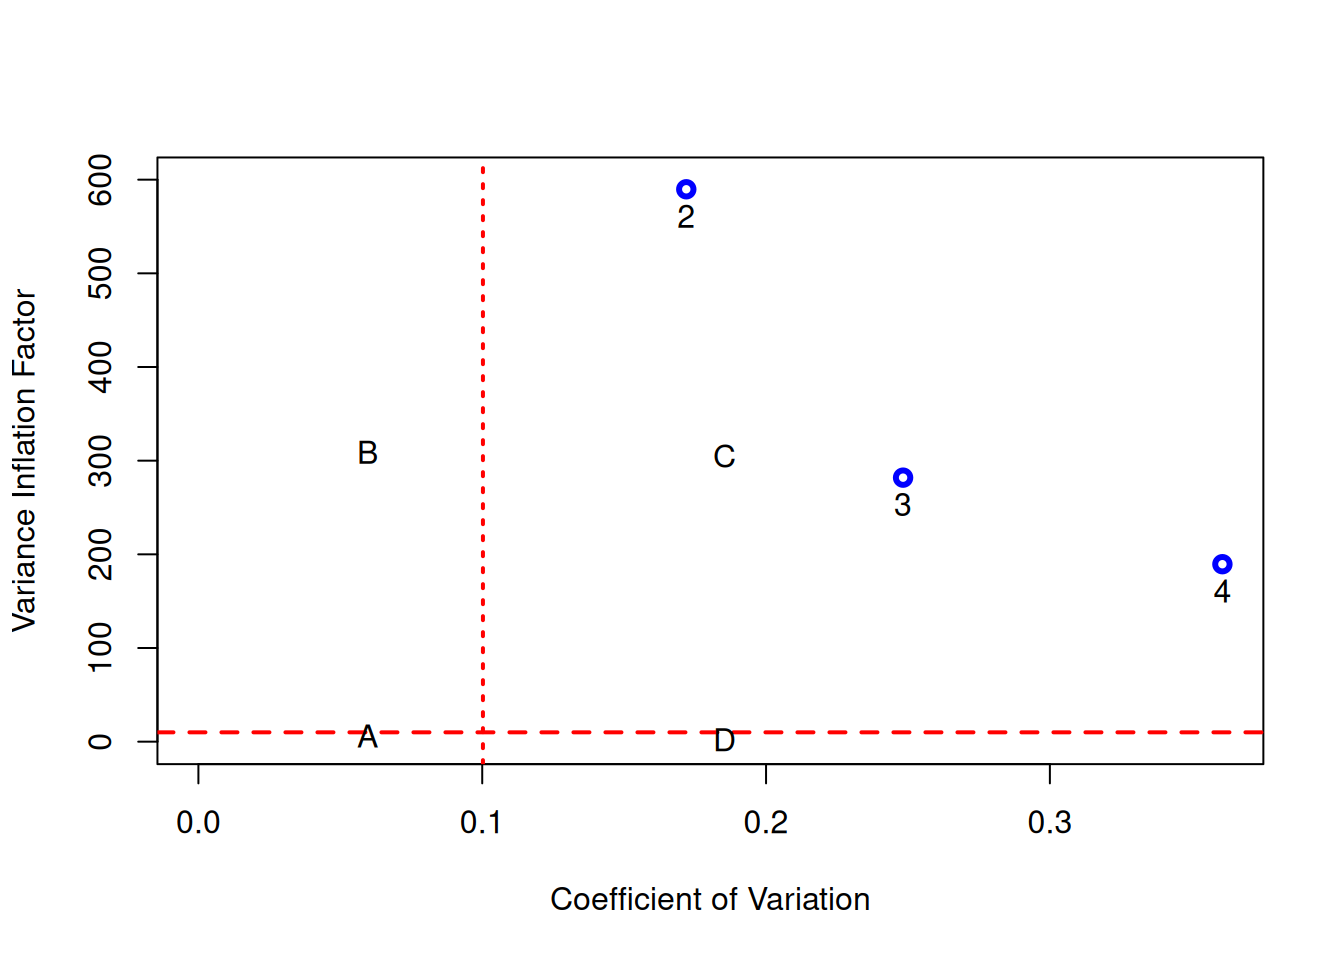
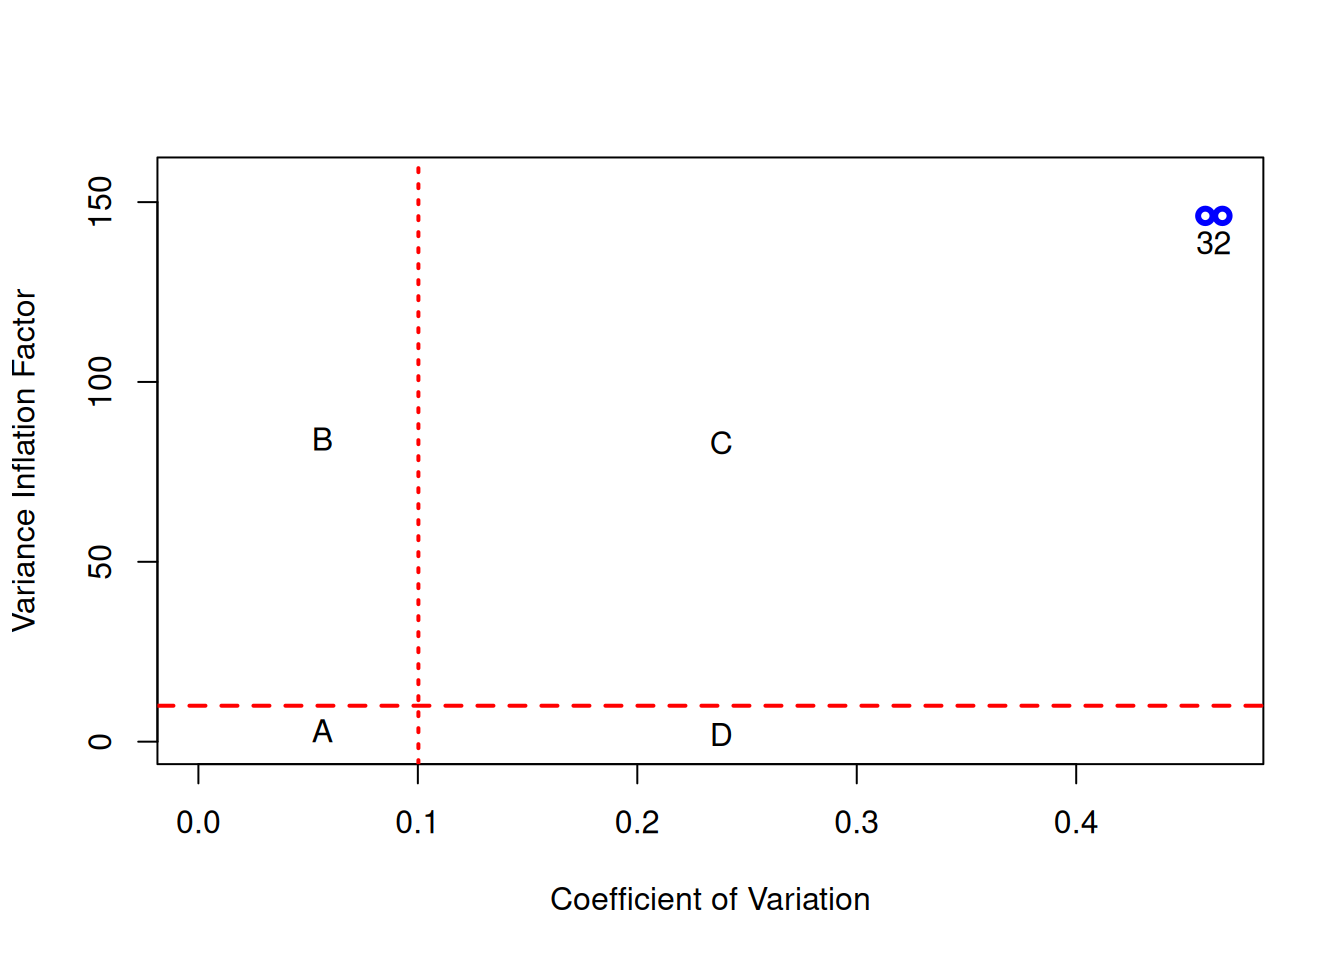
Además de proporcionar los distintos indicadores numéricos, la función multiCol() ofrece una representación gráfica del diagnóstico de multicolinealidad. En particular, el gráfico representa, para cada una de las variables explicativas, su factor de inflación de la varianza (FIV) y su coeficiente de variación (CV).
La principal ventaja de esta representación es que incorpora visualmente los umbrales de referencia utilizados para interpretar ambos indicadores. De esta forma, es posible identificar rápidamente qué variables pueden presentar problemas de multicolinealidad y distinguir, de manera orientativa, entre una posible multicolinealidad esencial, asociada a valores elevados del FIV, y una posible multicolinealidad no esencial, relacionada con una reducida variabilidad de la variable explicativa.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Para utilizar el paquete `multiCol` hay que crear la matriz de variables explicativas del modelo y, posteriormente, se pueden obtener globalmente todas las medidas mediante la función `multiCol`. Se observa que en este caso concreto, todos los indicadores presentan valroes por debajo de los ubrales preocupantes.
```{r}
n <- length(datos$ROA)

X <- cbind(
  rep(1, n),
  datos$LIQUIDEZ_INMEDIATA,
  datos$ENDEUDAMIENTO,
  datos$EMPLEADOS
)

multiCol(X)
```
:::
## Soluciones al problema de multicolinealidad
La multicolinealidad dificulta la estimación precisa de los efectos individuales de las variables explicativas. Sin embargo, su tratamiento no debe plantearse de forma automática: antes de aplicar una solución es necesario identificar qué tipo de multicolinealidad existe y cuál es su origen. En primer lugar, vamos a presentar algunas soluciones habituales de caracter básico y luego presentaremos brevemente otros métodos de estimación alternativos a MCO como soluciones más avanzadas.
### Soluciones básicas habituales
- Mejorar el diseño muestral. Cuando la multicolinealidad tiene un **componente errático**, puede estar relacionada con las características particulares de la muestra. En este caso, una posible solución consiste en aumentar el tamaño muestral y, cuando sea posible, incrementar la variabilidad de las variables explicativas. De esta forma, se obtiene una mayor cantidad de información para identificar los efectos individuales de los regresores.
- Centrar las variables explicativas. Cuando la multicolinealidad aproximada es **no esencial**, es decir, está relacionada con una escasa variabilidad de alguna variable y su relación con el término independiente, puede ser conveniente centrar dicha variable respecto de su media:
$$
X_i^c=X_i-\overline{X}_i.
$$
El centrado modifica la interpretación del término independiente, pero no altera la información contenida en la variable. Esta transformación puede reducir los problemas asociados a la relación entre el regresor y el intercepto.
- Eliminar o combinar variables explicativas. Cuando la multicolinealidad es **esencial**, puede existir una relación lineal elevada entre dos o más variables explicativas. Si desde el punto de vista económico o teórico algunas variables aportan información muy similar, una alternativa consiste en eliminar una de ellas o construir una medida conjunta que recoja la información común.
Estas soluciones son las primeras que deben considerarse porque mantienen, en la medida de lo posible, la interpretación habitual de los estimadores MCO. Alternativamente, pueden usarse estimadores alternativos como el estimador de mínimos cuadrados restringidos (si existen restricciones teóricas) o el **estimador cresta (ridge )** [@Hoerl1970b], la **estimador alzado (raise)** [@Garcia2010] o el **estimador residualizado**.
### Soluciones avanzadas
Cuando la multicolinealidad persiste y no resulta conveniente modificar la muestra, centrar las variables o eliminar alguno de los regresores, pueden utilizarse procedimientos de estimación alternativos a MCO.
#### Estimación cresta {.unnumbered}
@Hoerl1970b y @Hoerl1970a proponen la **estimación cresta**(ridge) cuyos
estimadores se obtienen como:
$$\hat{\boldsymbol{\beta}}_R(k)=\left(\mathbf{X}'\mathbf{X}+k\mathbf{I}\right)^{-1}\mathbf{X}'\mathbf{Y}, \quad k\geq 0.$$
La idea fundamental consiste en introducir una cantidad positiva $k$ en la diagonal de $\mathbf{X}'\mathbf{X}$. De esta forma, se evita que la proximidad a la singularidad de dicha matriz genere varianzas excesivamente elevadas.
La principal característica de este procedimiento es que introduce un sesgo controlado en los estimadores a cambio de conseguir una reducción de su varianza. Por tanto, frente al estimador MCO, se establece un compromiso entre sesgo y varianza.
Una de las dificultades de la estimación cresta es la elección del parámetro $k$. Además, los estimadores obtenidos mediante este procedimiento deben interpretarse teniendo en cuenta que ya no son estimadores MCO insesgados.
Una vez aplicada la estimación cresta, también es necesario comprobar si efectivamente se ha reducido la multicolinealidad. Tradicionalmente se había extendido al estimador cresta la expresión del FIV utilizada en MCO. Sin embargo, esta extensión puede proporcionar valores inadecuados del FIV, incluso inferiores a uno, por lo que se recomienda usar la expresión presentada por @Garcia2015.
### Estimación alzada
Otra alternativa es la estimación alzada (raise), propuesta por @Garcia2010 y @Garcia2016. Este procedimiento aborda la multicolinealidad desde una perspectiva geométrica.
Consideremos, para simplificar, un modelo con dos variables explicativas:
$$
\beta_1\mathbf{x}_1+
\beta_2\mathbf{x}_2+
\mathbf{u}.
$$
La multicolinealidad aparece cuando los vectores $\mathbf{x}_1$ y $\mathbf{x}_2$ se encuentran próximos entre sí. Puede expresarse:
$$
\mathbf{x}_1=
\rho\mathbf{x}_2+
\mathbf{e}_1,
$$
donde $\mathbf{e}_1$ es ortogonal a $\mathbf{x}_2$.
La estimación alzada modifica el vector $\mathbf{x}_1$ mediante:
$$
\mathbf{x}_1+
\lambda\mathbf{e}_1.
$$
De esta forma, se incrementa el ángulo entre los vectores explicativos y se reduce su relación lineal. Cuanto mayor sea el parámetro $\lambda$, mayor será la separación entre los vectores y, en consecuencia, menor será la correlación entre ellos.
El parámetro $\lambda$ debe seleccionarse cuidadosamente, ya que una modificación excesiva de los regresores puede afectar a las propiedades e interpretación de las estimaciones.
### Estimador ortogonal (residualization)
Una tercera alternativa es la estimación residualizada, también denominada regresión ortogonal, presentada por @Novales y formalmente desarrollada por @garcia2020.
La idea consiste en mantener una de las variables explicativas, considerada más importante desde el punto de vista económico, y sustituir la otra por la parte que no puede explicarse mediante la primera.
Asi, partiendo del modelo
$$\mathbf{y} = \beta_{1} \mathbf{x}_{1} + \beta_{2} \mathbf{x}_{2} + \mathbf{u}$$
donde las variables están estandarizadas. Dicha metodología se basa en sustituir una de las variables exógenas del modelo de regresión (aquella considerada menos importante) por sus componentes no explicados por la otra variable exógena (considerada más relevante para el fenómeno que se está intentando explicar).
Considerando que $\mathbf{x}_{1}$ tiene mayor importancia que $\mathbf{x}_{2}$, por lo que se desea mantenerla intacta, se estima la regresión auxiliar en la que la $\mathbf{x}_{1}$ aparezca como independiente. Al estimar esta regresión auxiliar por MCO se consigue expresar la $\mathbf{x}_{2}$ como una combinación de $\mathbf{x}_{1}$ y los residuos del modelo, esto es, $\mathbf{x}_{2} = \widehat{\alpha} \mathbf{x}_{1} + \mathbf{e}$.
Dichos residuos, que son ortogonales a $\mathbf{x}_{1}$, sustituyen a $\mathbf{x}_{2}$ en el modelo original dando lugar al modelo ortogonal:
$$\mathbf{y} = \beta_{1O} \mathbf{x}_{1} + \beta_{2O} \mathbf{e} + \mathbf{u}$$
y se interpretan como la parte de la segunda variable que no tiene
relación con la primera.
## Prácticas resueltas
### Crédito Estados Unidos. Análisis de los efectos de existencia de multicolinealidad aproximada y medidas de diagnóstico. {.unnumbered}
A partir de la base de datos de Wissel que incluye información sobre las
siguientes variables:
$D$ = deuda pendiente de hipoteca (billones de dólares)
$C$ = consumo personal (billones de dólares)
$I$ = ingresos personales (billones de dólares)
$CP$ = crédito al consumidor pendiente (billones de dólares).
Se pide:
```{r, echo=FALSE}
library(multiColl)
library(rvif)
data("Wissel")
attach(Wissel)
```
1. Estimar el modelo y comentar la significatividad individual y global
del modelo.
```{r}
reg = lm(D~C+I+CP, data=Wissel)
summary(reg)
```
2. Perturbar las variables explicativas un 1% con la función *perturb*
del paquete *multiCol* y analizar la variación en los estimadores:
```{r}
C_p=perturb(I,1,1,0.01)
valores=cbind(C,C_p)
reg_p = lm(D~C_p+I+CP, data=Wissel)
summary(reg_p)
```
3. Calcula la matriz de correlación y comenta los resultados.
```{r}
X=cbind(D,C,I,CP)
cor(X)
```
4. Calcular el factor inflactor de la varianza a partir de las
regresiones auxiliares.
Se puede realizar la regresión de cada una de las variables explicativas
en función del resto y analizar a partir del coeficiente de
determinación de dichas regresiones:
```{r}
reg_aux_C = lm(C~I+CP, data=Wissel)
reg_aux_I = lm(I~C+CP, data=Wissel)
reg_aux_CP = lm(CP~C+I, data=Wissel)
R2_C=summary(reg_aux_C)$r.squared
R2_I=summary(reg_aux_I)$r.squared
R2_CP=summary(reg_aux_CP)$r.squared
FIV_C=1/(1-R2_C)
FIV_I=1/(1-R2_I)
FIV_CP=1/(1-R2_CP)
vif=c(FIV_C,FIV_I,FIV_CP)
```
5. Calcula el factor inflactor de la varianza usando la función
correspondiente del paquete multiCol.
```{r}
n <- length(D)
cte = rep(1, n)
X=cbind(cte,C,I,CP)
VIF(X)
```
6. Calcular el número de condición a partir del paquete *multiCol*
teniendo y sin tener en cuenta el termino independiente e interpreta
los resultados.
```{r}
n <- length(D)
cte = rep(1, n)
X=cbind(cte,C,I,CP)
CNs(X)
```
7. Calcular los coeficientes de variación de las variables:
Igualmente, se podría calcular el coeficiente de variación de las
variables explicativas:
```{r}
cv <- function(x) { (sd(x) / mean(x)) * 100 }
cv(Wissel$C)
cv(Wissel$I)
cv(Wissel$Cr)
```
8. Usa la función *multiCol* para obtener todas las medidas de
diagnóstico conjuntamente e interpretalas:
```{r}
multiCol(X)
```
### Wooldridge. Aplicación de la estimación residualizada. {.unnumbered}
A partir de los datos de @Wooldrigde2000 se estima un modelo que analiza
los tipos de interés a 12 meses en función de los tipos de interés a 3 y
6 meses. Se pide:
```{r}
TI = read.table("data/WooldrigdeTI.txt", header=T)
```
1. Estima el modelo que explique los rendimientos a doce meses en
función de los rendimientos a 3 y a 6 meses e intepreta los
coeficientes estimados.
```{r}
reg = lm(r12~r3+r6, data=TI)
summary(reg)
```
2. Estima por separado el modelo que explique los rendimientos a doce
meses en función de los rendimientos a tres meses, y otro en fución
de los rendimientos a seis meses. Interpreta los coeficientes
estimados y comenta si ves incoherencias con el modelo estimado en
el punto anterior.
```{r}
reg_r3 = lm(r12~r3, data=TI)
summary(reg_r3)
reg_r6 = lm(r12~r6, data=TI)
summary(reg_r6)
```
3. Obtén las principales medidas de diagnóstico de multicolinealidad.
```{r}
library(multiColl)
attach(TI)
n <- length(r3)
cte = rep(1, n)
X=cbind(cte,r3,r6)
multiCol(X)
```
4. Aplicación el estimador residualizado para estimar el modelo.
Como se comento anteriormente, el signo obtenido en el estimador que acompaña a la variable r3 no es coherente. Podemos considerar que r3 esta contenida dentro de r6 y aplicar el método de estimación de residualización:
```{r}
reg_aux = lm(r6~r3)
summary(reg_aux)
e=residuals(reg_aux)
```
Esos residuos se pueden interpretar como la parte de r6 que no esta explicada por r3. Tengase en cuenta que r3 y los residuos (e) van a ser variables ortogonales entre si.
Sustituimos en la regresión original la variable r6 por la variable residuos (e) que se podrá interpretar como la parte de r6 no explicada por r3.
```{r}
reg_r = lm(r12~r3+e)
summary(reg_r)
```
Notesé que en este caso, la variable que se ha ortogonalizado mantiene el mismo valor para el estimador del parámetro que la acompaña, sin embargo es importante destacar que ha cambiado la interpretación de la variable ya que no sería la variable r6 original, sino la parte de r6 no explicada por r3. Esta metodología no podría usarse de forma automática sino que debe tenerse en cuenta si la variable ortogonalizada tiene una interpretación coherente dentro del contexto de la investigación que se este realizando.
### Tratamiento de la multicolinealidad exacta en R. Trampa de las variables ficticias. {.unnumbered}
Usando la base de datos *mtcars* que contiene las siguientes variables:
mpg = millas por galón
cyl = cilindros
hp = caballos de fuerza
disp = Mide el volumen del motor y representa el poder que genera el
motor
wt = peso (1000 lbs)
*qsec = 1/4 milla de tiempo (Tiempo que se demora el carro en recorrer
1/4 de milla)*
vs = tipo de cilindros (en V; en línea o Serie)
am = Trasmisión (0=automático, 1=manual)
gear = número de engranajes de la trasmisión
carb = número de carburadores
1. Estima un modelo que explique las millas por galon en función de los caballos y el peso expresado en libras y en kilogramos. Comenta el resultado obtenido.
```{r}
data(mtcars)
head(mtcars)
summary(mtcars)
mtcars$wt_kg <- mtcars$wt*100/2
modelo <- lm(mpg ~ hp + wt+wt_kg, data = mtcars)
summary(modelo)
```
2. Convierte la variable cyl en una variable cualitativa y estima el modelo incluyendo la variable dicótomica de cada una de las categorias.
```{r}
mtcars$cyl <- as.factor(mtcars$cyl)
dummies <- model.matrix(~ cyl - 1, data = mtcars)
modelo <- lm(mpg ~ hp + wt + dummies, data = mtcars)
```
3.Estima ahora el mismo modelo, pero sin incluir el termino constante. Comenta los resultados.
```{r}
modelo <- lm(mpg ~ hp + wt + dummies-1, data = mtcars)
```
### Precio helado. Tratamiento y diagnóstico de la multicolinealidad de tipo no esencial. {.unnumbered}
A partir de los datos del ejemplo 9.1 de Ramanatahn que estudia durante períodos de cuatro semanas desde el 18 de marzo de 1951 hasta el 11 de julio de 1953 el consumo per cápita de helado en pintas (demand) en función del ingreso familiar semanal en dólares (income), el precio del helado en dólares por pinta (price) y la temperatura media en grados Fahrenheit (temp), se pide:
1. Estime el modelo:
```{r}
icecream = read.table("data/data9-1.txt", header=T, sep="", stringsAsFactors = FALSE)
head(icecream)
summary(icecream)
modelo=lm(demand~income+price+temp, data=icecream)
summary(modelo)
```
2. Uso del paquete multiColl para el diagnóstico de la multicolinealidad:
```{r Calculo del VIF}
library(multiColl)
cte = array(1,length(icecream$demand))
X = cbind(cte,icecream[,-(1)])
FIV=VIF(X)
```
```{r Calculo del NC}
CNs(X)
```
```{r Calculo del CV}
CV(icecream$income)
CV(icecream$price)
CV(icecream$temp)
```
3. Proponga una solución para mitigar la multicolinealidad detectada y compruebe que se ha mitigado.
Dado que se ha detectado multicolinealidad de tipo no esencial, la propuesta es centrar la variable que la ocasiona. Para ello:
```{r}
icecream$price=icecream$price-mean(icecream$price)
modelo1=lm(demand~income+price+temp, data=icecream)
summary(modelo1)
X = cbind(cte,icecream[,-(1)])
FIV=VIF(X)
CNs(X)
```
### Modelo STIRPAT. Multicolinealidad no esencial y esencial. {.unnumbered}
Se trata de aplicar el modelo STIRPAT a datos de China (1990-2014) estimando el modelo que explica las emisiones de CO2 en función de la población total en miles de millones, el PIB per cápita (expresados en billones de dólares constantes de 2010) y la industrialización (como un porcentaje del PIB).
```{r}
stirpatchina <- read.csv("data/stirpattchina.csv", row.names=1, sep=";")
attach(stirpatchina)
x1<-Pop
x2<-PIBpc_cte
x3<-Indust
y<-CarbonDiox
n = length(y)
```
Se pide:
1. Calcular las medidas básicas de detección de multicolinealidad.
```{r}
cte = rep(1, length(n))
X = cbind(cte, x1, x2, x3)
VIF(X)
CN(X)
CVs(X)
```
Se observa que el NC es mayor que 30 mientras que los FIV son menores de 10, aunque mayor que 4 en el caso de la primera y segunda variable explicativa. Se concluye que existe multicolinealidad no esencial y según los coeficientes de variación son la primera y la tercera variables explicativas las que presentan un coeficiente de variación inferior a 0.10,
2. Proponga una solución para el tipo de multicolinealidad detectada. Y compruebe si se ha mitigado.
De la conclusión anterior se obtiene que existe multicolinealidad no esencial generadas por la primera y tercera variable, por lo que se procede a centrar dichas variables:
```{r}
x1_c = x1 - mean(x1)
x3_c = x3 - mean(x3)
X_c = cbind(cte, x1_c, x2, x3_c)
```
se procede a recalcular las medidas de detección:
```{r}
VIF(X_c)
CN(X_c)
```
Observamos que se ha mitigado la multicolinealidad no esencial, pero la esencial parece seguir existiendo entre la primera y la segunda variable.
3. Aplique el método de residualización:
Para ello se procede a estimar la variable x2 (PIB per cápita) en función de la variable X1 (Población) y la variable x3 (tecnología)
```{r}
aux = lm(x2 ~ x1+x3)
x2resid = aux$residuals
```
La variable resultante se interpretaria como el PIB per cápita que no esta relacionado ni con la población ni con la tecnología. A continuación, se sustituye en el modelo la variable x2 por su residualización.
```{r}
modelo_residual = lm(y ~ x1_c + x2resid + x3_c)
summary(modelo_residual)
```
Si analizamos las medidas de diagnóstico de la multicolinealidad para ese modelo se observa que se ha mitigado.
```{r}
X_r = cbind(cte, x1_c, x2resid, x3_c)
VIF(X_r)
CN(X_r)
```
## Prácticas propuestas
1. Usar el paquete multiColl para analizar la posible existecia de multicolinealidad en el modelo $ROA_i=\beta_0+\beta_1LIQUIDEZ_i+\beta_2ENDEUDAMIENTO_i+\beta_3INDICEFINACIEROAPROX_i+u_i$.
2. Usar el paquete multiColl para analizar la posible existecia de multicolinealidad en el modelo $IBEX35_i=\beta_0+\beta_1SP500+\beta_2EUROSTOXX50_i+u_i$.
3. A partir de la base de datos Inditex que relaciona las ventas con el número de empleados y el número de tiendas para el periodo 2006-2020, se pide:
a. Obtener la matriz de correlaciones de las variables. Comentar el signo de los coeficientes esperados.
b. Estimar el modelo e interpretar los coeficientes.
c. Interpretar los estadísticos experimentales del test de significación individual a partir del p-valor.
d. Interpretar el estadístico experimental del test de significación global a partir del p-valor.
e. Realizar el contraste sobre si el efecto del número de tiendas puede ser igual al de número de empleados.
f. Calcula la regresión auxiliar del número de empleados en función del número de tiendas y obtén el factor inflactor de la varianza a partir de él.
g. Obtén a través del software el factor inflactor de la varianza y el número de condición.
Vamos a realizar los siguientes modelos alternativos:
Modelo 2: Construye la variable ratio de empleado por tienda e introdúcela en el modelo.\\
Modelo 3: A partir del año 2010 el grupo comienza el comercio electrónico. Crea una variable ficticia que recoja este efecto e introdúcela en el modelo junto con la anterior.\\
Modelo 4 (Residualización): Realizamos la regresión del número de empleados en función del número de tiendas y nos quedamos con los residuos. De manera que sustituimos en el modelo 1, el número de empleados por dichos residuos (parte de la variable número de empleados que no está relacionada con el número de tiendas) y se estima nuevamente el modelo.
Comparar todos los modelos en función de la bondad del ajuste.