```{r}
#| include: false
library(readxl)
library(dplyr)
library(knitr)
library(ggplot2)
library(car)
library(strucchange)
```
# Modelo de regresión lineal
::: {.callout-important title="Objetivos de aprendizaje"}
Al finalizar este capítulo, el estudiante será capaz de:
- Comprender las hipótesis del modelo de regresión lineal múltiple y explicar su importancia para la validez de los resultados econométricos.
- Estimar modelos de regresión lineal múltiple mediante el método de mínimos cuadrados ordinarios (MCO) utilizando datos de empresas y mercados financieros.
- Interpretar económicamente los coeficientes estimados, distinguiendo entre el efecto individual de cada variable explicativa y su influencia conjunta sobre la variable dependiente.
- Evaluar la calidad del ajuste de un modelo mediante las principales medidas de bondad de ajuste y comparar especificaciones alternativas para seleccionar el modelo más adecuado.
- Realizar inferencia estadística sobre los parámetros del modelo mediante intervalos de confianza y contrastes de hipótesis, tanto individuales como conjuntos.
- Contrastar la significación global del modelo y valorar su capacidad explicativa desde una perspectiva económica y estadística.
- Analizar las propiedades básicas de los estimadores obtenidos mediante MCO y comprender las consecuencias del incumplimiento de las hipótesis del modelo.
- Utilizar el modelo estimado para realizar predicciones e interpretar los resultados en contextos empresariales y financieros.
- Evaluar la estabilidad de un modelo econométrico mediante contrastes de permanencia estructural y comprender su importancia cuando se analizan datos de distintos periodos o entornos económicos.
- Aplicar todas estas herramientas al análisis de la rentabilidad empresarial y de los mercados financieros utilizando R como herramienta de trabajo.
:::
## Hipótesis del modelo
EL modelo lineal uniecuacional múltiple analiza la relación lineal entre una variable dependiente, $Y$, y más de una variable independiente, $X_{j}$, $j=1,\dots,k$, $k > 1$, más un término aleatorio, $u$. Con una muestra de tamaño $n$, el modelo puede ser expresado como:
$$Y_{i} = \beta_{1} + \beta_{2} X_{2i} + \beta_{3} X_{3i} +
\cdots + \beta_{k} X_{ki} + u_{i}, \quad i=1,\dots,n,$$
donde se ha considerado que hay término constante, es decir, $X_{1i} = 1$, $\forall i$. Normalmente se usa el subíndice $i$ para trabajar con datos de caracter transversal y el subíndice $t$ para trabajar con datos de caracter temporal.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Aunque en la teoria la variable dependiente suele denotarse como $Y$ y las variables explicativas como $X$, en la práctica lo habitual es que las variables tomen el nombre de las siglas de la medida a la que representan o similar. Asi, en nuestro ejemplo, el modelo se denota como:
$$
ROA_i=\beta_0+\beta_1LEV_i+\beta_2LIQ_i+u_i
$$
Notese que el parámetro $\beta_0$ no esta multiplicado por ninguna variable explicativa por lo que podría considerarse que esta multiplicada por 1, que es a lo que llamamos el término independiente o intercepto. Tengase en cuenta tambien que el subindice $i$ se usa para denotar que tenemos $n=100$ observaciones, de manera que en esa ecuación se esta representando una observación (empresa) concreta $i$. En cambio, los parámetros no tienen subindice porque son constantes desconocidas que describen la relación entre las variables y se supone que son comunes a todas las observaciones de la muestra.
:::
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
En el ejemplo con datos financieros, estamos trabajando con datos temporales referidos a $n=72$ meses. El modelo econométrico quedaría especificado como:
como:
$$
IBEX35_t=\beta_0+\beta_1SP500_t+\beta_2EUROSTOXX50_t+u_t
$$
Es habitual usar el subíndice $t$ cuadno trabajamos con datos de series temporales.
:::
Dado que cada variable se observa para las $n$ observaciones de la muestra, puede representarse mediante un vector de dimensión $n×1$. En consecuencia, el modelo de regresión puede escribirse de forma más compacta utilizando notación matricial, lo que simplifica su formulación teórica y el desarrollo de los resultados que se estudiarán a lo largo del capítulo:
$$y = X \cdot \beta + u,$$
Consideraremos las siguientes **hipótesis básicas** en el modelo lineal uniecuacional múltiple:
1. El vector $y$ se puede expresar como combinación lineal de las variables explicativas más un vector de perturbación.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
La rentabilidad económica de una empresa puede explicarse, al menos parcialmente, mediante una relación lineal con variables observables como el endeudamiento y la liquidez, junto con otros factores no observados recogidos en la perturbación aleatoria.
:::
2. No hay relación entre variables independientes y la perturbación aleatoria, es decir, $$Cov ( u_{n \times 1}, X_{j} ) = 0_{n\times n}.$$
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Se supone que las variables explicativas no contienen información sobre los factores no observados incluidos en la perturbación. Por ejemplo, si la calidad del equipo directivo afecta simultáneamente al endeudamiento y al ROA pero no se incorpora al modelo, esta hipótesis podría incumplirse.
:::
3. La matriz $X$ es no estocástica y de rango completo por columnas, es decir, $rg(X) = k$ (como consecuencia $n > k$ y las columnas de $X$, es decir, $X_{i}$, $i=1,\dots,n$, son linealmente independientes).
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Si el modelo incorpora simultáneamente el ratio de endeudamiento y otro indicador calculado exactamente como el doble del anterior, ambas variables contienen la misma información y el modelo no podrá estimarse.
:::
4. Las perturbaciones aleatorias son esféricas, es decir:
4.1 Está centrada: $$E[u_{i}] =0, \ i=1,\dots,n$$
4.2 Es homoscedástica: $$Var(u_{i}) = E[u_{i}^{2} ] = \sigma^{2}, \ i=1,\dots,n $$
4.3 Es incorrelada: $$Cov(u_{i}, u_{j}) = E[u_{i} \cdot u_{j}] = 0, \ \forall i \not= j, i,j=1,\dots,n $$ El incumplimiento de la hipótesis (3) da lugar a la existencia de colinealidad perfecta. Igualmente, el incumplimiento de las hipótesis (4.b) y (4.c) dan lugar a la existencia de heterocedasticidad y autocorrelación, respectivamente.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
| Hipótesis | Interpretación práctica |
| ---------------- | --------------------------------------------------------------------------- |
| Media cero | Los factores omitidos no producen un sesgo sistemático en la rentabilidad. |
| Homocedasticidad | La variabilidad de los errores es similar para empresas pequeñas y grandes. |
| Incorrelación | La variable no observable de una empresa no esta relacionada con variable no observable de otra empresa. |
:::
Estas hipótesis no se introducen únicamente por razones matemáticas. Permiten demostrar que el estimador de mínimos cuadrados ordinarios posee propiedades deseables, como la insesgadez y la eficiencia. Además, muchas de ellas podrán comprobarse posteriormente mediante contrastes específicos. Además de estas hipótesis, para llevar a cabo lo que se conoce como inferencia tradicional (intervalos de confianza y contrastes de hipótesis basados en una distribución estadística) se impondrá como hipótesis adicional que la perturbación aleatoria se distribuya según una distribución Normal de media 0 y varianza $\sigma^2I$.
## Estimación de los parámetros del modelo por mínimos cuadrados ordinarios. Propiedades
El método de mínimos cuadrados ordinarios (MCO) es el procedimiento más utilizado para estimar un modelo de regresión lineal. Su objetivo consiste en encontrar los valores de los parámetros que hacen que las predicciones del modelo sean lo más próximas posible a los datos observados. En otras palabras, busca la recta (o, en el caso de varias variables, el hiperplano) que mejor se ajusta a la información disponible.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
En el caso de estudio del libro, el modelo intenta explicar la rentabilidad económica (ROA) de las empresas a partir del endeudamiento y la liquidez, y el objetivo es obtener un modelo estimado del tipo:
$$\hat{ROA}=17.5061-0.3133LIQUIDEZ-0.1522ENDEUDAMIENTO$$
Una vez estimado el modelo, cada empresa tendrá un ROA estimado y un ROA observado. La diferencia entre ambos valores constituye el residuo.
| Empresa | ROA | Endeudamiento | Liquidez | ROA estimado | Residuos |
|:-------:|------:|--------------:|---------:|-------:|-------:|
| A | 4.12 | 63.756 | 0.11 | 7.7679 | -3.6479|
| B | 1.604| 79.32 | 0.037 | 5.4220 | -3.818|
| C | 4.646 | 64.678 | 0.042| 7.6489 | -3.0029|
| D | 10.828 | 11.881 | 2.058 | 15.0530 | -4.2250|
| E | 4.916 | 81.242 | 0.028 | 5.1322 | -0.2163|
| F | 11.147 | 41.208 | 0.693 | 11.0171 | 0.1298|
| ... | ... | ... | ...| ... | ... |
Podría pensarse en minimizar simplemente la suma de los residuos. Sin embargo, los residuos positivos y negativos se compensan entre sí, de modo que su suma siempre es cero cuando el modelo incorpora término independiente. Por este motivo se minimiza la suma de los cuadrados de los residuos (SCR), que penaliza por igual los errores positivos y negativos y concede mayor importancia a los errores de mayor magnitud.
:::
Matemáticamente, el objetivo se traduce en estimar la recta que minimice la diferencia entre el valor real y el valor estimado. Dicha diferencia se conoce como residuo $e$, y se obtiene como $e = y - \widehat{y},$ donde $\widehat{y} = X \widehat{\beta}$. Dado que se verifica que la suma de los residuos es cero ($\sum_{i=1}^{n} e_i=0$), el objetivo será minimizar la suma de los cuadrados de los residuos (SCR). Los pasos a seguir son:
- **Paso 1: Definir la función objetivo**. Se establece la expresión a minimizar que viene dada por:
$$e^{t}e = (y - X \widehat{\beta})^{t} \cdot (y - X \widehat{\beta}) = y^{t}y - 2 \widehat{\beta}^{t} X^{t} y + \widehat{\beta}^{t} X^{t} X \widehat{\beta},$$
- **Paso 2. Encontrar el mínimo**. Se deriva la expresión obtenida con respecto a $\widehat{\beta}$ y se iguala a cero. $$ \frac{\partial e^{t} e}{\partial {\widehat{\beta}}} =- 2 X^t {y}+ 2 X^t X {\widehat{\beta}}={0}$$ Esta expresión corresponde a la condición necesaria de mínimo de la función en estudio.
- **Paso 3. Obtener el estimador MCO**. A continuación se despeja el vector de parámetros de la expresión anterior: $$ - 2 X^t {y}+ 2 X^t X {\widehat{\beta}}= {0}
\Leftrightarrow
X^t X {\widehat{\beta}}= X^t {y} \notag$$ obteniendo $$\widehat{\beta} = \left( X^{t} X \right)^{-1} \cdot X^{t}y$$.
- **Paso 4. Comprobar que realmente es un mínimo**. Se puede demostrar que igualmente se verifica la condición suficiente $$\frac{\partial^2 e^{t} e }{\partial {\widehat{\beta}} \partial {\widehat{\beta}}^t} =2 X^t X>0$$
Por tanto, el estimador MCO viene dado por la siguiente expresión:
$${\widehat{\beta}} = \left(X^t X\right)^{-1} \left( X^t {y} \right)$$
Es posible obtener el producto $X^{t} X$ y $X^{t}y$ a partir de las siguientes expresiones:
$$X^{t} X = \left(
\begin{array}{cccc}
n & \sum \limits_{t=1}^{n} X_{2i} & \cdots & \sum \limits_{i=1}^{n} X_{ki} \\
\sum \limits_{i=1}^{n} X_{2i} & \sum \limits_{i=1}^{n} X_{2i}^{2} & \cdots & \sum \limits_{i=1}^{n} X_{2i} X_{ki} \\
\vdots & \vdots & \ddots & \vdots \\
\sum \limits_{i=1}^{n} X_{ki} & \sum \limits_{i=1}^{n} X_{ki} X_{2i} & \cdots & \sum \limits_{i=1}^{n} X_{ki}^{2} \\
\end{array} \right),$$
\noindent y
$$X^{t} y = \left(
\begin{array}{c}
\sum \limits_{i=1}^{n} Y_{i} \\
\sum \limits_{i=1}^{n} X_{2i} Y_{i} \\
\vdots \\
\sum \limits_{i=1}^{n} X_{ki} Y_{i} \\
\end{array} \right).$$
Esta expresión proporciona los estimadores de los parámetros del modelo utilizando únicamente la información contenida en la matriz de variables explicativas y en el vector de la variable dependiente. Aunque su cálculo puede realizarse manualmente en ejemplos sencillos mediante el producto de matrices y el cálculo de la inversa de una matriz, en la práctica usaremos programas estadísticos como R mediante la función `lm`. Sin embargo, el conocimiento de la expresión anterior permite comprender el fundamento matemático del método de estimación.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
A continuación, aplicamos la función `lm` a nuestro ejemplo para obtener los estiamdores MCO:
```{r}
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")
modelo <- lm(
    ROA ~ ENDEUDAMIENTO + LIQUIDEZ_INMEDIATA,
    data = datos
)
modelo
```
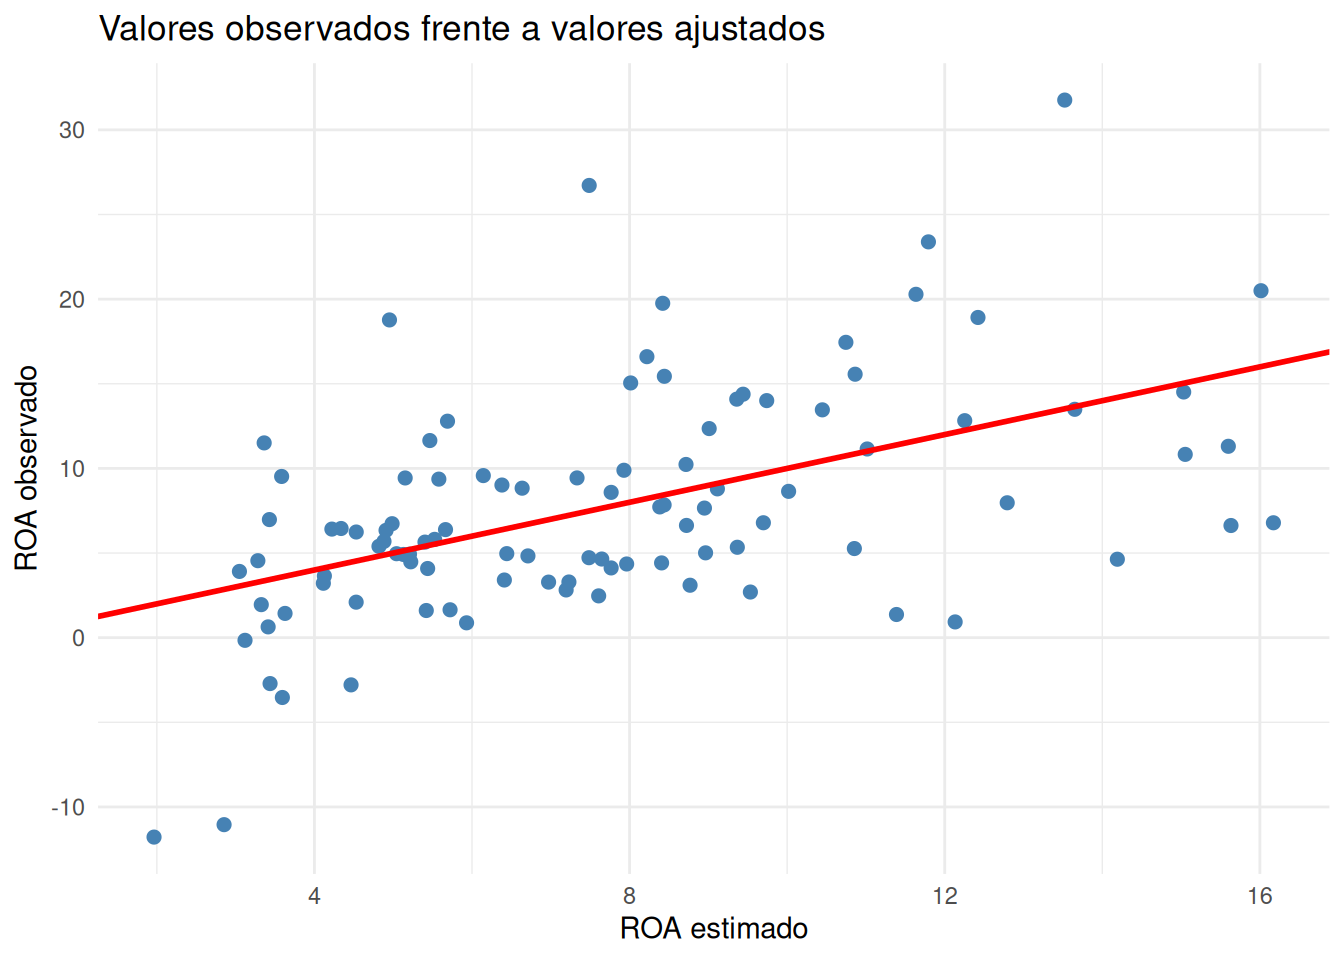
Graficamente, se puede representar el gráfico de los valores observados frente a la recta estimada:
```{r}
datos$ROA_estimado <- fitted(modelo)

ggplot(datos, aes(x = ROA_estimado, y = ROA)) +
  geom_point(color = "steelblue", size = 2) +
  geom_abline(intercept = 0, slope = 1,
              color = "red", linewidth = 1) +
  labs(
    title = "Valores observados frente a valores ajustados",
    x = "ROA estimado",
    y = "ROA observado"
  ) +
  theme_minimal()
```
Igualmente, se pueden obtener los residuos:
```{r}
modelo$residuals
```
:::
Como consecuencia de la estimación mediante MCO se derivan las siguientes propiedades algebraicas de los estimadores:
| Propiedad | Interpretación |
| ----------------- | ------------------------------------------------------------------ |
| $(X' e=0)$ | Los residuos son ortogonales a las variables explicativas. |
| $(i'e=0)$ | La suma de los residuos es cero. |
| $(i'\hat y=i'y)$ | La media de los valores estimados coincide con la media observada. |
| $(\hat y' e=0)$ | Los valores ajustados y los residuos no están correlacionados. |
### Teorema de Gauss-Markov
En el modelo de regresión lineal, los parámetros $\beta_1,\beta_2,\ldots,\beta_k$ son **constantes desconocidas** que describen la relación existente entre la variable dependiente y las variables explicativas. Aunque sus valores son fijos, no pueden observarse directamente y, por tanto, deben estimarse a partir de una muestra de datos.
Los valores obtenidos mediante el método de mínimos cuadrados ordinarios, $\widehat{\beta}_1,\widehat{\beta}_2,\ldots,\widehat{\beta}_k$, reciben el nombre de **estimadores**. A diferencia de los parámetros, los estimadores son **variables aleatorias**, ya que dependen de la muestra utilizada para realizar la estimación. Si se extrajeran repetidamente muestras distintas de la misma población y se estimara el modelo en cada una de ellas, los valores obtenidos para los coeficientes serían diferentes.
Como cualquier variable aleatoria, los estimadores poseen una distribución de probabilidad y, por tanto, pueden caracterizarse mediante propiedades como su esperanza matemática y su varianza. En consecuencia, al evaluar un procedimiento de estimación interesa que los estimadores presenten determinadas propiedades deseables. Dos de las propiedades más importantes son las siguientes:
- **Insesgadez**: un estimador es insesgado cuando, en promedio, coincide con el verdadero valor del parámetro que pretende estimar. Matemáticamente, se puede demostrar:
$$
\begin{aligned}
\widehat{\beta}
&= \left( X^{t}X \right)^{-1} X^{t}y \\
&= \left( X^{t}X \right)^{-1} X^{t}(X\beta + u) \\
&= \beta + \left( X^{t}X \right)^{-1} X^{t}u.
\end{aligned}
$$
Por tanto,
$$
\widehat{\beta}
=
\beta + \left( X^{t}X \right)^{-1} X^{t}u.
$$
Dado que $E[u] = 0$, se cumple que:
$$
\begin{aligned}
E[\widehat{\beta}]
&= E\left[
\beta + \left( X^{t}X \right)^{-1} X^{t}u
\right] \\
&= \beta + \left( X^{t}X \right)^{-1} X^{t}E[u] \\
&= \beta.
\end{aligned}
$$
Por lo que se ha demostrado que $\widehat{\beta}$ es un **estimador insesgado**. Esto significa que, si el proceso de muestreo pudiera repetirse un gran número de veces, el promedio de los estimadores obtenidos coincidiría con el verdadero valor del parámetro poblacional.
- **Eficiencia**: entre dos estimadores insesgados, se considera más eficiente aquel que presenta una menor varianza. Un estimador eficiente produce estimaciones menos dispersas alrededor del verdadero valor del parámetro y, por tanto, proporciona resultados más precisos.
Para demostrar que el estimador MCO es eficiente se calcula en primer lugar la matriz de varianzas-covarianzas de $\widehat{\beta}$:
$$
\begin{aligned}
Var\left(\widehat{\beta}\right)
&= E\left[
\left(\widehat{\beta} - E[\widehat{\beta}]\right)
\left(\widehat{\beta} - E[\widehat{\beta}]\right)^{t}
\right] \\
&= E\left[
\left(\widehat{\beta} - \beta\right)
\left(\widehat{\beta} - \beta\right)^{t}
\right] \\
&= E\left[
\left(X^{t}X\right)^{-1}X^{t}u
u^{t}X\left(X^{t}X\right)^{-1}
\right] \\
&= \left(X^{t}X\right)^{-1}X^{t}
E\left[uu^{t}\right]
X\left(X^{t}X\right)^{-1} \\
&= \sigma^{2}
\left(X^{t}X\right)^{-1}X^{t}X
\left(X^{t}X\right)^{-1} \\
&= \sigma^{2}\left(X^{t}X\right)^{-1}.
\end{aligned}
$$
donde se ha tenido en cuenta que $\widehat{\beta}$ es insesgado, que
$$
\widehat{\beta} - \beta
=
\left(X^{t}X\right)^{-1}X^{t}u
$$
y que
$$
Var(u) = E\left[uu^{t}\right]
= \sigma^{2}I_{n \times n}.
$$
A continuación, se procede a demostrar que $\widehat{\beta}$ es el estimador de mínima varianza de entre todos los estimadores lineales e insesgados. Para ello, se considera otro estimador, $\beta^{*}$, de $\beta$, lineal e insesgado, de forma que $Var(\widehat{\beta}) < Var(\beta^{*})$. En efecto,
$$
\beta^{*} = D_{k \times n}y_{n \times 1},
$$
tal que
$$
DX = I_{k \times k},
$$
es lineal e insesgado. Además,
$$
Var\left(\beta^{*}\right)
=
\sigma^{2}DD^{t}.
$$
En tal caso, puesto que podemos escribir
$$
D = \left(X^{t}X\right)^{-1}X^{t} + W,
$$
con
$$
W \neq 0_{k \times n},
$$
se tiene que
$$
DD^{t}
=
\left(X^{t}X\right)^{-1} + WW^{t},
$$
y, en tal caso:
$$
\begin{aligned}
Var\left(\beta^{*}\right)
&= \sigma^{2}DD^{t} \\
&= \sigma^{2}\left(X^{t}X\right)^{-1}
+ \sigma^{2}WW^{t} \\
&= Var\left(\widehat{\beta}\right)
+ \sigma^{2}WW^{t}.
\end{aligned}
$$
Esto es,
$$
Var\left(\beta^{*}\right)
-
Var\left(\widehat{\beta}\right)
=
\sigma^{2}WW^{t}.
$$
Debido a que $WW^{t}$ es definida positiva:
$$
Var\left(\beta^{*}\right)
-
Var\left(\widehat{\beta}\right)
> 0.
$$
Por tanto,
$$
Var\left(\beta^{*}\right)
>
Var\left(\widehat{\beta}\right).
$$
Los resultados obtenidos en la demostración anterior constituyen precisamente los elementos fundamentales del **Teorema de Gauss-Markov** que establece que, bajo las hipótesis del modelo lineal clásico, los estimadores obtenidos mediante el método de mínimos cuadrados ordinarios (MCO) son lineales e insesgados y, además, presentan la mínima varianza entre todos los estimadores lineales e insesgados. Por esta razón, se denominan Estimadores Lineales Insesgados Óptimos (ELIO) o, utilizando la terminología anglosajona, Best Linear Unbiased Estimators (BLUE). Ver @Wooldridge2000 para más detalle.
**Varianza de la perturbación aleatoria**\\
Además de los coeficientes de las variables independientes, es necesario estimar la varianza de la perturbación aleatoria, $\sigma^{2}$. Puede demostrarse que la suma de cuadrados de los residuos verifica la siguiente propiedad:
$$E[e^{t} e] = (n-k) \cdot \sigma^{2}$$
por lo que un estimador insesgado de la varianza de la perturbación aleatoria viene dado por
$$
\widehat{\sigma}^{2} = \frac{e^{t} e}{n-k}
$$
Una vez estimada la varianza residual, puede obtenerse la matriz estimada de varianzas y covarianzas de los estimadores MCO $\widehat{\beta}$:
$$\widehat{Var \left( \widehat{\beta} \right)} = \widehat{\sigma}^{2} \cdot \left( X^{t} X \right)^{-1}.$$
Los elementos de la diagonal principal de esta matriz contienen las **varianzas** de cada uno de los coeficientes estimados, mientras que los elementos situados fuera de la diagonal representan las **covarianzas** entre ellos. A partir de esta matriz se obtienen los **errores estándar** de los coeficientes, que desempeñan un papel esencial en la inferencia estadística y permiten construir intervalos de confianza y realizar contrastes de significación sobre los parámetros del modelo, aspectos que se estudiarán en las siguientes secciones.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
En el caso de estudio del libro, el teorema de Gauss-Markov garantiza que, si se cumplen las hipótesis del modelo, los coeficientes que relacionan el ROA con el endeudamiento y la liquidez son los más precisos que pueden obtenerse mediante un estimador lineal e insesgado. Esto aumenta la fiabilidad de las conclusiones extraídas sobre la influencia de ambas variables en la rentabilidad empresarial.
Hay que tener en cuenta que los coeficientes estimados que relacionan el ROA con el endeudamiento y la liquidez indican el efecto medio de cada variable sobre la rentabilidad empresarial. Sin embargo, estos coeficientes son estimaciones obtenidas a partir de una muestra de empresas y, por tanto, están sujetos a incertidumbre. La matriz de varianzas-covarianzas cuantifica esa incertidumbre y permite determinar si los efectos estimados son estadísticamente significativos o podrían deberse al azar. Esta idea constituye la base de la inferencia estadística que se desarrolla en los apartados siguientes.
Se puede obtener la suma de los cuadrados de los residuos (SCR)
```{r}
SCR <- deviance(modelo)
SCR
```
Y, a partir de ella, obtener la estimación de la varianza de las perturbaciones:
```{r}
n <- nobs(modelo)
k <- length(coef(modelo))

sigma2 <- SCR / (n - k)
sigma2
```
También se puede obtener directamente, como:
```{r}
sigma(modelo)^2
```
La matriz de varianzas-covarianzas de los estimadores puede obtenerse mediante:
```{r}
vcov(modelo)
```
El resultado es una matriz cuadrada cuyos elementos de la diagonal representan las varianzas de los estimadores de los coeficientes, mientras que los elementos fuera de la diagonal corresponden a sus covarianzas. Asi, se verifica que:\\
- $\hat{var}(\hat{\beta}_0)=8.0246$
- $\hat{var}(\hat{\beta}_1)=0.0013$
- $\hat{var}(\hat{\beta}_2)=2.7307$
- $\hat{cov}(\hat{\beta_0},\hat{\beta_1})=-0.100$
- $\hat{cov}(\hat{\beta_0},\hat{\beta_2})=-3.7175$
- $\hat{cov}(\hat{\beta_1},\hat{\beta_2})=0.0434$
:::
### Interpretación de los estimadores
Estimar un modelo econométrico constituye únicamente el primer paso del análisis. El verdadero interés radica en interpretar el significado económico de los coeficientes obtenidos y evaluar si sus magnitudes son coherentes con la teoría económica y financiera. En esta sección se estudia cómo interpretar los estimadores en función de la forma funcional del modelo.
Si partimos de un modelo de regresión estimado con dos variables explicativas más un termino independiente:
$$\hat{y}_t=\hat{\beta}_1+\hat{\beta}_2x_{2t}+\hat{\beta}_3x_{3_t}$$
Si expresamos el modelo en diferencias:
$$\hat{y}_i-\hat{y}_{i-1}=(\hat{\beta}_1+\hat{\beta}_2x_{2t}+\hat{\beta}_3x_{3_t})-(\hat{\beta}_1+\hat{\beta}_2x_{2t-1}+\hat{\beta}_3x_{3t-1})=$$ $$\Delta\hat{y}_t= \hat{\beta}_2\Delta x_{2t}+ \hat{\beta}_3 \Delta x_{3t}$$
Por tanto, si el incremento en $x_3$ es cero ($\Delta x_3=0$), entonces:
$$\hat{\beta}_2=\frac{\Delta \hat{y}_t}{\Delta X_{2t}}$$
por lo que $\hat{\beta}_2$ se interpreta como el cambio en $y$ producido por un cambio en $x_2$ manteniendose $x_3$ constante.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
En nuestro ejemplo, el modelo estimado tiene la siguiente expresión:
$$
\hat{ROA}_i=17.5061-0.1522LEV_i+-0.3133LIQ_i
$$
La interpretación de cada uno de los coeficientes es la siguiente:
- $\hat{\beta_0}$=17.5061. El intercepto indica que, si una empresa presentara un nivel de endeudamiento y de liquidez igual a cero, el ROA esperado sería del 17.5061 %. No obstante, esta situación no suele tener sentido económico, ya que es poco realista encontrar empresas con ambos ratios iguales a cero. Por ello, el término independiente suele tener una interpretación limitada.
- $\hat{\beta_1}$=−0.1522. Manteniendo constante la liquidez, un incremento de una unidad en el ratio de endeudamiento se asocia, en promedio, con una disminución de 0.1522 puntos porcentuales en el ROA. El signo negativo es coherente con la teoría financiera, ya que un mayor nivel de endeudamiento suele incrementar la carga financiera y el riesgo de la empresa, reduciendo su rentabilidad económica.
- $\hat{\beta_1}$=−0.3133. Manteniendo constante el nivel de endeudamiento, un incremento de una unidad en el ratio de liquidez se asocia, en promedio, con una reducción de 0.3133 puntos porcentuales en el ROA. Dado que podría esperarse una relación positiva entre liquidez y rentabilidad, deberá analizarse posteriormente mediante los contrastes de significación estadística.
Obsérvese que ambos coeficientes representan efectos marginales o efectos *ceteris paribus*. Es decir, cada coeficiente mide el efecto de una variable sobre el ROA suponiendo que el resto de las variables explicativas permanecen constantes. Esta es una de las principales ventajas de la regresión múltiple frente al análisis bivariante, ya que permite aislar el efecto individual de cada factor sobre la variable de interés.
:::
En algunas ocasiones, puede resultar interesante expresar la variables del modelo (dependiente, independiente o ambas) en logaritmos. Algunos ejemplos en los que puede resultar interesante trabajar con logaritmos son los siguientes:
- **Para linealizar modelos no lineales**. Por ejemplo la función de producción de Cobb-Douglas se expresa como una función no lineal del tipo: $$P_i=L_i^{\beta_1}\times K_i^{\beta_2} \times u_i$$ que se podría convertir en lineal tomando logaritmos: $$\ln{P_i}=\beta_1\ln(L_i)+\beta_2\ln(K_i)+ u_i$$
- **Para reducir la dispersión original de los datos**, ya que la forma funcional en logaritmos permite reducir la dispersión de la variable limitando el riesgo de aparición de heterocedasticidad (varianza no constante de la perturbación aleatoria)
Cuando ambas variables estan expresadas en logaritmo, la interpretación de los parámetros es similar al concepto de elasticidad entre ambas variables:
$$Elasticidad_{(y/x)}=\frac{\frac{\Delta y}{y}}{\frac{\Delta x}{x}}$$ por lo tanto: $$\frac{\Delta y}{y}=\beta_2 \frac{\Delta x}{x}\rightarrow log(y)=\beta_2 log(x)$$ Por lo que $\beta_2$ se interpreta como el cambio porcentual en $y$ ante una variación del 1% en la variable $x$.
En algunas ocasiones se combinaran variables expresadas en unidades originales (nivel) con otras expresadas en logaritmos y para interpretarlo correctamente hay que tener en cuenta que los cambios de la variable en logaritmos se asemejan a cambios porcentuales, mientras que los cambios en variables en nivel se expresan como cambios en la unidad original de esa varriable. Este cuadro presentado por @arce2012, resume las distintas interpretaciones:
| Especificación | Expresión | Interpretación de $\hat{\beta}_2$ |
|------------------------|----------------------------|--------------------|
| Nivel-Nivel | $y_i=\beta_1+\beta_2x_{2i}+u_i$ | Incremento de unidades en $y$ cuando aumenta 1 unidad la $x_2$ |
| Log-nivel | $log(y_i)=\beta_1+\beta_2x_{2i}+u_i$ | $\hat{\beta}_2\times100$ incremento porcentual de $y$ cuando aumenta una unidad $x_2$ |
| Nivel-log | $y_i=\beta_1+\beta_2log(x_{2i})+u_i$ | $\hat{\beta_2}/100$ incremento en unidades de $y$ cuando aumenta un 1% la variable $x_2$ |
| Log-Log | $log(y_i)=\beta_1+\beta_2log(x_{2i})+u_i$ | Incremento porcentual de $y$ cuando aumenta un 1% la variable $x_2$ |
: Resumen interpretación coeficientes
Este cuadro será completado incorporando la interpretación para el caso de variables dicotómicas dependiendo de si la variable dependiente esta expresada en unidades originales o en logaritmos.
## Bondad de ajuste: coeficientes de determinación y criterios de Akaike y Schwarz
Una vez estimados los coeficientes del modelo surge una pregunta natural: ¿explica bien el modelo el comportamiento de la variable dependiente? Para responder a esta cuestión existen diversas medidas de bondad del ajuste. Ninguna de ellas permite decidir por sí sola si un modelo es adecuado, pero proporcionan información muy útil para comparar especificaciones alternativas y valorar su capacidad explicativa.
Así, una vez obtenidos los estimadores de los parámetros, interesa conocer qué proporción de la variabilidad observada de la variable explicada consigue explicar el modelo y qué parte permanece sin explicar.
### Descomposición de la variabilidad
La variabilidad total observada en la variable dependiente puede descomponerse en dos partes:
- la variabilidad explicada por el modelo, que recoge la información explicada por las variables independientes;
- la variabilidad no explicada, correspondiente a los residuos o errores de estimación.
Esta descomposición puede expresarse mediante la identidad
$$SCT=SCE+SCR$$
donde:
- SCT es la Suma de Cuadrados Total
$$
SCT=y^{t} y - n \cdot \overline{Y}^{2}
$$
- SCE es la Suma de Cuadrados Explicada
$$
SCE=\widehat{\beta}^{t} X^{t} y - n \cdot \overline{Y}^{2}
$$
- SCR es la Suma de Cuadrados de los Residuos.
$$
SCR=y^{t}y - \widehat{\beta}^{t} X^{t} y
$$
Obsérvese que esta descomposición únicamente se verifica cuando el modelo incorpora un término independiente.
### Coeficiente de determinación
La medida de bondad del ajuste más utilizada es el coeficiente de determinación, denotado por $R^{2}$, se obtiene como el cociente entre SCE y SCT:
$$R^{2} = \frac{SCE}{SCT} = 1 - \frac{SCR}{SCT}.$$
Mide la proporción de la variabilidad total de la variable dependiente que consigue explicar el modelo de regresión. Asi, el coeficiente de determinación varía entre 0 y 1, siempre que el modelo lineal tenga término independiente.
- Cuando la SCE es nula, el modelo no explica nada y el coeficiente de determinación, toma el valor 0.
- Por otra parte, cuando la SCR es nula, el modelo explica el 100% de la varianza y, por tanto, el coeficiente de determinación toma el valor 1.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Por ejemplo, en el modelo del ROA se obtiene un coeficiente de determinación igual a 0.2582, significa que el 25.82 % de la variabilidad observada en la rentabilidad económica de las empresas queda explicada por el endeudamiento y la liquidez, mientras que el 74.18 % restante se debe a otros factores no incluidos en el modelo o al componente aleatorio.
```{r}
summary(modelo)$r.squared
```
:::
El coeficiente de determinación presenta el inconveniente de que aumenta a medida que se incluyen variables en el modelo aunque las variables incluidas no sean significativas. Por esta razón, el coeficiente de determinación no permite comparar modelos con distinto número de variables explicativas.
### El coeficiente de determinación corregido:
Para resolver este inconveniente se utiliza el coeficiente de determinación corregido, denotado por $\overline{R}^{2}$. Se define como:
$$
\overline{R}^{2} = 1 - (1 - R^{2}) \cdot \frac{n-1}{n-k}.
$$
A diferencia del coeficiente de determinación, esta medida incorpora una penalización por el número de parámetros estimados. En consecuencia, únicamente aumenta cuando la incorporación de nuevas variables mejora realmente la capacidad explicativa del modelo.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Si estimamos un modelo alternativo en el que, por error, se incorpora como variable explicativa el código identificador de la empresa (numeradas del 1 al 100), cabría esperar que el modelo no mejorase, ya que dicha variable no contiene información económica relacionada con el ROA. Sin embargo, al volver a estimar el modelo se observa que el coeficiente de determinación ($R^2$) aumenta ligeramente. Esto ocurre porque el $R^2$ nunca disminuye al añadir nuevas variables explicativas, aunque estas sean completamente irrelevantes. En cambio, el coeficiente de determinación corregido penaliza la incorporación de variables adicionales y, en este caso, pone de manifiesto que la aparente mejora del ajuste desaparece. Este ejemplo ilustra por qué el $R^2$ corregido resulta más adecuado que el $R^2$ para comparar modelos con distinto número de variables explicativas.
```{r}
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")
set.seed(1234)

# Variable aleatoria independiente del resto
datos$ID <- 1:nrow(datos)

modelo_id <- lm(
    ROA ~ ENDEUDAMIENTO + LIQUIDEZ_INMEDIATA+ID,
    data = datos
)
# Comparación
data.frame(
  Modelo = c("Original", "Con ID"),
  R2 = c(summary(modelo)$r.squared,
         summary(modelo_id)$r.squared),
  R2_corregido = c(summary(modelo)$adj.r.squared,
                   summary(modelo_id)$adj.r.squared)
)
```
:::
### Otros criterios de información
Otra forma de comparar modelos consiste en utilizar los criterios de información, que combinan dos aspectos fundamentales:
- la capacidad de ajuste del modelo;
- su complejidad, medida por el número de parámetros estimados.
Los criterios más utilizados son el criterio de información de Akaike (AIC) y el criterio bayesiano de Schwarz (BIC), definidos respectivamente por
$$
AIC = - 2 \cdot \mathfrak{L} + 2 \cdot k.
$$
$$
BIC = - 2 \cdot \mathfrak{L} + k \cdot \ln (n),
$$
donde $\mathfrak{L} = - \frac{n}{2} \cdot \left( 1 + \ln (2 \cdot \pi) - \ln (n) \right) - \frac{n}{2} \cdot \ln (SCR).$
Ambos criterios penalizan la incorporación de nuevas variables explicativas. Aunque añadir variables suele reducir la suma de cuadrados de los residuos, también incrementa la complejidad del modelo. El AIC y el BIC buscan un equilibrio entre ambas cuestiones. Por tanto, cuando se comparan varios modelos estimados sobre la misma muestra y con la misma variable dependiente, será preferible aquel que presente el menor valor de AIC o BIC.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Vamos a estimar el modelo, pero solo considerando como variable explicativa la LIQUIDEZ_INMEDIATA:
```{r}
modelo1 <- lm(
  ROA ~ LIQUIDEZ_INMEDIATA,
  data = datos)
```
Y, considerando la LIQUIDEZ_INMEDIATA, el ENDEUDAMIENTO y el número de EMPLEADOS:
```{r}
modelo2 <- lm(
  ROA ~ LIQUIDEZ_INMEDIATA + ENDEUDAMIENTO + EMPLEADOS,
  data = datos
)
```
Por último, añadimos la variable EBIT:
```{r}
modelo3 <- lm(
  ROA ~ LIQUIDEZ_INMEDIATA + ENDEUDAMIENTO + EMPLEADOS+EBIT,
  data = datos
)
```
Podemos realizar la siguiente comparación usando distintas medidas de bondad:
```{r}
comparacion <- data.frame(
  Modelo = c(
    "Liquidez + Endeudamiento",
    "Liquidez",
    "Liquidez + Endeudamiento + Empleados",
    "Liquidez + Endeudamiento + Empleados+EBIT"
  ),
  R2 = c(
    summary(modelo)$r.squared,
    summary(modelo1)$r.squared,
    summary(modelo2)$r.squared,
    summary(modelo3)$r.squared
  ),
  R2_corregido = c(
    summary(modelo)$adj.r.squared,
    summary(modelo1)$adj.r.squared,
    summary(modelo2)$adj.r.squared,
    summary(modelo3)$adj.r.squared
  ),
  AIC = c(
    AIC(modelo),
    AIC(modelo1),
    AIC(modelo2),
    AIC(modelo3)
  ),
  BIC = c(
    BIC(modelo),
    BIC(modelo1),
    BIC(modelo2),
     BIC(modelo3)
  )
)

comparacion
```
:::
## Estimación mediante intervalos de confianza de los parámetros del modelo
En el apartado anterior se obtuvo una estimación puntual de cada parámetro del modelo. Sin embargo, una estimación puntual proporciona únicamente un valor concreto obtenido a partir de la muestra disponible. Como cualquier estimación está sujeta a variabilidad muestral, resulta necesario cuantificar la incertidumbre asociada a dicho valor. Para ello se estudia la distribución de los estimadores a partir de la distribución de la perturbación aleatoria, lo que permitirá construir intervalos de confianza y realizar posteriormente contrastes de hipótesis sobre los parámetros del modelo.
#### Distribución de la perturbación aleatoria {.unnumbered}
Para poder obtener intervalos de confianza y realizar contrastes de hipótesis mediante la inferencia clásica se añade una hipótesis adicional a las vistas anteriormente: se supone que la perturbación aleatoria sigue una distribución Normal.
$$
u_{n \times 1} \sim N(0_{n \times 1}, \sigma^{2} \cdot I_{n \times n})
$$
#### Distribución del estimador {.unnumbered}
Partiendo de la distribución de la perturbación aleatoria se puede obtener la distribución del estimador.
$$
\hat{\beta}=\beta+\left( X^{t} X \right)^{-1} X^{t} u,
$$
entonces se verifica que $\hat{\beta}$ se distribuye según una normal con
$$
E \left[\widehat{\beta} \right] = \beta, \quad
Var \left( \widehat{\beta} \right) = \sigma^{2} \cdot \left( X^{t} X \right)^{-1},
$$
es decir:
$$
\widehat{\beta}_{k \times 1} \sim N\!\left(\beta, \ \sigma^{2} \cdot \left( X^{t} X \right)^{-1} \right).
$$
#### Intervalo de confianza {.unnumbered}
De esta forma, es inmediato obtener los siguientes intervalos de confianza al nivel $1-\alpha$ para $\beta_{i}$
$$
\widehat{\beta}_{i} \pm t_{n-k} \left( 1 - \frac{\alpha}{2} \right) \cdot
\cdot \sqrt{\widehat{var}(\hat{\beta_i})}, \quad i=1,\dots,k.
$$
siendo $\widehat{var}(\hat{\beta_i})=\hat{\sigma}^2\times w_{i}$ donde $w_{i}$ es el elemento $(i,i)$ de la matriz $(X'X)^{-1}$. El intervalo de confianza proporciona un conjunto de valores plausibles para el verdadero parámetro poblacional. Cuanto menor sea la variabilidad del estimador, más estrecho será el intervalo y mayor será la precisión de la estimación.
::: {.callout-caution title="Error habitual interpretación del intervalor de confianza"}
Un intervalo de confianza del 95 % no significa que exista un 95 % de probabilidad de que el parámetro pertenezca al intervalo calculado.
Significa que, si el procedimiento de muestreo pudiera repetirse un gran número de veces, aproximadamente el 95 % de los intervalos construidos contendrían el verdadero valor del parámetro.
:::
Por otro lado, se puede obtener también el intervalo de confianza para $\sigma^{2}$:
$$
\left[ \frac{(n-k) \cdot \widehat{\sigma}^{2}}{\chi^{2}_{n-k} \left( 1 - \frac{\alpha}{2} \right)}, \
\frac{(n-k) \cdot \widehat{\sigma}^{2}}{\chi^{2}_{n-k} \left( \frac{\alpha}{2} \right)} \right]
$$
donde $\chi^{2}_{n-k} \left( 1 - \frac{\alpha}{2} \right)$ y $\chi^{2}_{n-k} \left( \frac{\alpha}{2} \right)$ son los puntos de una distribución chi-cuadrado con $n-k$ grados de libertad que dejan a su izquierda, respectivamente, una probabilidad $1 - \frac{\alpha}{2}$ y $\frac{\alpha}{2}$.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Calculamos mediante la función `confint` los itnervalos de confianza que por defecto se obtienen al 95%.
```{r}
confint(modelo3)
```
Pero tambien, se puede obtener al 90%:
```{r}
confint(modelo3, level = 0.90)
```
Al 99%, o a cualquier otro nivel que se desee:
```{r}
confint(modelo3, level = 0.99)
```
Notesé que el nivel de confianza influye directamente en la amplitud del intervalo de confianza. Cuanto mayor es el nivel de confianza, mayor es la probabilidad de que el intervalo contenga el verdadero valor del parámetro, pero para conseguir esa mayor seguridad es necesario construir un intervalo más amplio. Por el contrario, cuanto menor es el nivel de confianza, menor es la certeza de que el intervalo incluya el parámetro poblacional y, en consecuencia, el intervalo resulta más estrecho. Así, un intervalo de confianza del 99 % será siempre más amplio que uno del 95 %, y este, a su vez, será más amplio que un intervalo del 90 %. En la práctica existe un compromiso entre precisión y confianza: niveles de confianza elevados proporcionan mayor seguridad, pero a costa de obtener estimaciones menos precisas al aumentar la amplitud del intervalo.
:::
Además de proporcionar una medida de la precisión de las estimaciones, los intervalos de confianza permiten realizar una primera valoración sobre la relevancia de cada variable explicativa. En particular, resulta especialmente interesante comprobar si el intervalo de confianza de un coeficiente contiene o no el valor cero. Si el intervalo incluye el cero, significa que existen valores plausibles del parámetro para los cuales el efecto de la variable sobre la variable dependiente podría ser nulo. En consecuencia, con el nivel de confianza considerado no puede descartarse que dicha variable no tenga influencia sobre la variable explicada. Por el contrario, si el intervalo de confianza no contiene el cero, todos los valores plausibles del parámetro son positivos o negativos, lo que constituye una evidencia de que la variable ejerce un efecto significativo sobre la variable dependiente.
Esta forma de razonar está estrechamente relacionada con los contrastes de hipótesis. En la práctica es habitual complementar su interpretación mediante contrastes de hipótesis, que permiten tomar decisiones de forma objetiva sobre la significación estadística de cada coeficiente.
## Contrastes de hipótesis acerca de los parámetros del modelo
En el apartado anterior se han construido intervalos de confianza para los coeficientes del modelo. Sin embargo, en muchas ocasiones el investigador desea responder a preguntas concretas sobre los parámetros estimados. Por ejemplo:
- ¿Influye realmente el endeudamiento sobre la rentabilidad de las empresas?
- ¿el endeudamiento y la liquidez tienen el mismo efecto?
- ¿el IBEX35 replica exactamente al SP500?
Todas estas cuestiones pueden formularse como contrastes de hipótesis, cuya formulación general se presenta a continuación. Para ello, lo primero es formular la hipótesis en forma de restricción.
### Estadístico general de contraste
Una restricción lineal consiste en imponer una determinada condición sobre uno o varios parámetros del modelo. Por ejemplo, las preguntas anteriores se podrían formular en forma de restricción de la siguiente manera:
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
$$ROA_i=\beta_0+\beta_1LEV_i+\beta_2LIQ_i+u_i$$
- ¿Influye realmente el endeudamiento sobre la rentabilidad de las empresas?
$$ \beta_1=0$$
- ¿el endeudamiento y la liquidez tienen el mismo efecto?
$$ \beta_1=\beta_2$$
:::
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
$$
IBEX35_t=\beta_0+\beta_1SP500_t+\beta_2EUROSTOXX50_t+u_t
$$
- ¿el IBEX replica exactamente al SP500?
$$ \beta_1=1$$
:::
Este conjunto de restricciones se puede resumir planteando una hipótesis nula del tipo:
$$
H_{0}: R \beta = r
$$
donde $R$ es la matriz de restricciones que tiene tantas filas como restricciones tenga el modelo ($q$) y tantas columnas como parámetros ($k$). Cada valor $a_{qk}$ toma el valor 0 si el parámetro $k$ no está afectado por la restricción $q$, y en el caso de que sí lo esté, toma el coeficiente correspondiente:
$$
R_{q \times k} = \begin{pmatrix}
a_{11} & a_{12} & \dots & a_{1k} \\
a_{21} & a_{22} & \dots & a_{2k} \\
\vdots & \vdots & \ddots & \vdots \\
a_{q1} & a_{q2} & \dots & a_{qk}
\end{pmatrix}
$$
y $r$ es el vector de resultados:
$$
r_{q \times 1} = \begin{pmatrix}
b_{1} \\
b_{2} \\
\vdots \\
b_{q}
\end{pmatrix}
$$
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
$$ROA_i=\beta_0+\beta_1LEV_i+\beta_2LIQ_i+u_i$$
Suponiendo que queremos analizar conjuntamente ambas hipótesis $\beta_1=0$ y $\beta_1=\beta_2$, se reescribiría como $\beta_1=0$ y $\beta_1-\beta_2=0$ y la matriz de restricciones se definiria como:
$$
R=
\begin{pmatrix}
0 & 1 & 0 \\
0 & 1 & -1
\end{pmatrix}
$$
y $r$
$$
r=
\begin{pmatrix}
0 \\
0
\end{pmatrix}
$$
:::
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
$$
IBEX35_t=\beta_0+\beta_1SP500_t+\beta_2EUROSTOXX50_t+u_t
$$
Suponiendo que queremos analizar $\beta_1=1$
$$
R=
\begin{pmatrix}
0 & 1 & 0
\end{pmatrix}
$$
y $r$
$$
r=1
$$
:::
Una vez establecidas la matriz de restricciones y el vector de resultados, se obtiene el estadístico experimental a partir de la distribución:
$$
\left( R \widehat{\beta} - R \beta \right)^{t} \cdot
\frac{\left[ R \left( X^{t} X \right)^{-1} R^{t} \right]^{-1}}{q \cdot \widehat{\sigma}^{2}} \cdot
\left( R \widehat{\beta} - R \beta \right) \sim F_{q,n-k}
$$
De manera que rechazaremos la hipótesis nula al nivel de significación $\alpha$ si:
$$
\left( R \widehat{\beta} - r \right)^{t} \cdot
\frac{\left[ R \left( X^{t} X \right)^{-1} R^{t} \right]^{-1}}{q \cdot \widehat{\sigma}^{2}} \cdot
\left( R \widehat{\beta} - r \right) > F_{q,n-k} (1 - \alpha)
$$
donde $F_{q,n-k} (1 - \alpha)$ es el cuantil de la distribución $F$ de Snedecor con $q$ y $n-k$ grados de libertad.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Partiendo del modelo:
$$ROA_i=\beta_0+\beta_1LEV_i+\beta_2LIQ_i+u_i$$
para contrastar conjuntamente $\beta_1=0$ y $\beta_1-\beta_2=0$, obtenemos previamente:
```{r}
b <- coef(modelo)
X <- model.matrix(modelo)
sigma2 <- summary(modelo)$sigma^2
R <- rbind(
  c(0, 1, 0),
  c(0, 1, -1)
)
r <- c(0,0)
q <- nrow(R)
```
Y, a partir de ello, se calcula el estadístico:
```{r}
Fexp <-
t(R %*% b - r) %*%
solve(R %*% solve(t(X)%*%X) %*% t(R)) %*%
(R %*% b - r) /
(q * sigma2)
Fexp
```
y se puede obtener el valor critico al 95%:
```{r}
gl1 <- q
gl2 <- df.residual(modelo)
qf(0.95, gl1, gl2)
```
De manera que se concluye que se rechaza la hipótesis nula al 95% de confianza. Esto implica que los datos proporcionan evidencia suficiente para concluir que las restricciones impuestas no se verifican simultáneamente. En otras palabras, al menos una de las restricciones planteadas sobre los parámetros del modelo no es compatible con la información contenida en la muestra.
:::
El contraste general permite evaluar cualquier conjunto de restricciones lineales sobre los parámetros del modelo, desde una única restricción hasta varias restricciones simultáneas. No obstante, en la práctica existen algunos casos particulares que se utilizan con mucha frecuencia. En estos casos, al sustituir la hipótesis correspondiente en la expresión general del estadístico de contraste, se obtienen formulaciones mucho más sencillas que facilitan tanto su interpretación como su aplicación.
### Contraste de una única restricción lineal
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
En el ejemplo financiero del IBEX 35 estimado a partir del siguiente modelo:
$$
IBEX35_t=\beta_0+\beta_1SP500_t+\beta_2EUROSTOXX50_t+u_t
$$
Se ha formulado anteriormente la hipótesis de que el IBEX 35 presente el mismo comportamiento que el SP500, es decir que $ \beta_1=1$
Este contraste constituye un caso particular del contraste general que se puede realizar con una expresión más simple.
:::
De forma general, si queremos contrastar úna unica hipótesis del tipo:
$$
H_{0}: \beta_{i} = b_{i}, \quad i=1,\dots,k
$$
donde $b_i$ es un valor conocido. En este caso $q=1$, $R = (0 \ \dots \ 1^{(i)} \ \dots \ 0)$ y $r=b_{i}$. La distribución se simplifica como:
$$
\frac{\left( \widehat{\beta}_{i} - b_{i} \right)^{2}}
{\widehat{\sigma}^{2} \cdot w_{i}} = \frac{\left( \widehat{\beta}_{i} - b_{i} \right)^{2}}
{\widehat{var}(\hat{\beta}_i)}\sim F_{1,n-k},
$$
recordemos que $w_{i}$ es el elemento $(i,i)$ de la matriz $(X^tX)^{-1}$, por lo que tambien se puede expresar como $\widehat{var}(\hat{\beta}_i)$. Teniendo en cuenta que la raíz cuadrada de una $F$ con 1 y $n$ grados de libertad sigue una $t$ de Student con $n$ grados de libertad:
$$
\frac{\widehat{\beta}_{i} - b_{i}}{\widehat{\sigma} \cdot \sqrt{w_{i}}}=\frac{\widehat{\beta}_{i} - b_{i}}{\sqrt{\widehat{var}(\hat{\beta}_i)}} \sim t_{n-k}
$$
Rechazaremos $H_{0}$ si:
$$
\left| \frac{\widehat{\beta}_{i} - b_{i}}{\widehat{\sigma} \cdot \sqrt{w_{i}}} \right|
> t_{n-k}\left(1 - \frac{\alpha}{2}\right)
$$
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
Si estimamos el modelo podemos obtener el estimador que acompaña a la variable Rend_SP500 que es igual a $\beta_2=-0.2056$:
```{r}
datos <- read_excel("data/BD_IBEX.xlsx", sheet = "Datos")
modeloIBEX<- lm(Rend_IBEX ~ Rend_SP500+ Rend_EUROSTOXX50,
    data = datos
)
modeloIBEX
```
A partir de la matriz de varianzas-covarianzas podemos obtener la estimación de la varianza del estimador que sera $\widehat{var}(\hat{\beta}_2)=0.012535714$
```{r}
vcov(modelo)
```
Por lo que el contraste quedaría formulado de la siguiente manera:
Hipótesis: H$_0$: $\beta_2=1$
Estadístico experimental:
$t_exp=\frac{-0.2056-1}{\sqrt{0.012535714}}=-10.7678$
Podemos calcular el valor teórico:
```{r}
gl <- df.residual(modelo)
alpha <- 0.05
t_teorico <- qt(1 - alpha/2, df = gl)
t_teorico
```
Y, finalmente concluir, que dado que el estadístico experimental es mayor que el valor crítico se rechaza la hipótesis nula.
:::
### Contraste de significación individual
El contraste de significación individual que se utiliza habitualmente es simplemente un caso particular del contraste anterior. La diferencia está en el valor que asignamos a la restricción. En lugar de preguntarnos si un parámetro es igual a un valor concreto, nos preguntamos si es igual a cero. Este último contraste permite determinar si el efecto asociado a una variable explicativa es estadísticamente diferente de cero. Por tanto, el contraste de significación individual no es un contraste distinto del que acabamos de estudiar, sino el caso particular de una única restricción lineal en el que el valor hipotetizado del parámetro es cero. Es decir, la hipótesis nula quedaría formulada:
$$H_{0}: \beta_{i} = 0$$
Si la hipótesis nula no se rechaza, no existe evidencia estadística suficiente para afirmar que la variable explicativa tiene un efecto distinto de cero sobre la variable dependiente, una vez controlado el efecto del resto de variables del modelo. Por el contrario, si la hipótesis nula se rechaza, puede concluirse que dicha variable contribuye de forma significativa a explicar la variable dependiente.
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
En el caso anterior, si queremos contrastar que $\beta_2=0$, partimos de los valores que hemos obtenido anteriormente para el estimador $\beta_2=-0.2056$ y su varianza, formulamos el contraste de la siguiente manera:
Hipótesis: H$_0$: $\beta_2=0$
Estadístico experimental:
$t_exp=\frac{-0.2056}{\sqrt{0.012535714}}=-1.837$
Podemos calcular el valor teórico al 95% de confianza y concluir dado que el valor absoluto del estadístico experimental es menor que el valor crítico no se puede rechazar la hipótesis nula.
```{r}
gl <- df.residual(modelo)
alpha <- 0.05
t_teorico <- qt(1 - alpha/2, df = gl)
t_teorico
```
Sin embargo, si obtenemos el valor critico al 90% de confianza, en ese caso el valor absoluto del estadístico experimental es mayor que el valor crítico por lo que se rechaza la hipótesis nula.
```{r}
gl <- df.residual(modelo)
alpha <- 0.1
t_teorico <- qt(1 - alpha/2, df = gl)
t_teorico
```
:::
En la práctica, los programas estadísticos no suelen comparar directamente el estadístico experimental con el valor crítico, sino que proporcionan el **p-valor** asociado al contraste.
#### Concepto de p-valor {.unnumbered}
El p-valor representa la probabilidad de obtener, bajo la hipótesis nula, un valor del estadístico de contraste tan extremo como el observado en la muestra. Por tanto, cuanto menor sea el p-valor, mayor será la evidencia que los datos proporcionan en contra de la hipótesis nula. Otra forma de interpretar el p-valor consiste en considerarlo como el menor nivel de significación que habría que elegir para rechazar la hipótesis nula, dada la realización muestral del estadístico. Esta interpretación permite establecer una regla de decisión que no depende de fijar previamente un único nivel de significación.
Si el contraste es **a dos colas**, el *valor-p* es dos veces el área de la realización muestral del estadístico en valor absoluto, en la distribución de éste bajo la hipótesis nula. Es decir:
$$
\text{valor-}p = 2 \, Pr(t_j > |t_j^m| \,/\, H_0)
$$
Si el contraste es **a una cola**, el *valor-p* es el área a la derecha de la realización muestral del estadístico en valor absoluto, en la distribución de éste bajo la hipótesis nula. Es decir:
$$
\text{valor-}p = Pr(t_j > t_j^m \,/\, H_0)
$$
En cualquier caso, a mayor *valor-p* menor la evidencia contra la hipótesis nula, y por el contrario, a menor *valor-p*, mayor evidencia contra la hipótesis nula.
**Regla de decisión:**\
Rechazar la hipótesis nula si el *valor-p* es menor que el nivel de significación elegido, y no rechazarla en caso contrario.
::: {.callout-caution title="Error habitual en la interpretación del p-valor"}
No debe interpretarse el p-valor como la probabilidad de que la hipótesis nula sea verdadera. El p-valor se calcula suponiendo que la hipótesis nula es cierta y mide la compatibilidad de los datos observados con dicha hipótesis.
:::
Por ejemplo, si un contraste presenta un p-valor de (0.03), la hipótesis nula se rechazaría al 5 %, ya que (0.03<0.05), pero no al 1 %, ya que (0.03>0.01). De este modo, el p-valor proporciona más información que una simple decisión de rechazo o no rechazo, ya que permite valorar hasta qué nivel de significación los datos permiten rechazar la hipótesis nula.
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
En R podemos usar la función `summary(modelo)`para ver un resumen del modelo estimado y nos facilita directamente los estimadores, su desviación típica, el valor del estadístico experimental del contraste de signficación individual y su p valor correspondiente.
```{r}
datos <- read_excel("data/BD_IBEX.xlsx", sheet = "Datos")
modeloIBEX <- lm(
    Rend_IBEX ~ Rend_SP500+ Rend_EUROSTOXX50,
    data = datos
)
summary(modeloIBEX)
```
La interpretación de las columnas que se obtiene con `summary(modelo)` es la siguiente:
- Estimate: recoge el valor estimado del coeficiente $\widehat{\beta}_i$.
- Std. Error: recoge el error estándar del estimador y, por tanto, una medida de la incertidumbre asociada a la estimación.
- t value: es el estadístico experimental del contraste de significación individual, que permite contrastar $H_0:\beta_i=0$.
- Pr(>|t|): es el p-valor asociado a dicho contraste.
R añade además una columna de significación mediante asteriscos. En nuestro ejemplo, el intercepto aparece acompañado de un asterisco (`*` ), el rendimiento del SP500 aparece acompañado de un punto (`.`) y el rendimiento del EuroStoxx 50 aparece acompañado de tres asteriscos (`***`).
Estos símbolos constituyen una forma rápida de identificar el nivel de significación estadística de cada coeficiente. Por defecto, R utiliza la siguiente clasificación:
| Símbolo | p-valor | Interpretación |
| :-----: | :---------: | ---------------------- |
| `***` | (p<0.001) | Significativo al 0,1 % |
| `**` | (p<0.01) | Significativo al 1 % |
| `*` | (p<0.05) | Significativo al 5 % |
| `.` | (p<0.10) | Significativo al 10 % |
| | (p\geq0.10) | No significativo |
Por tanto, en nuestro ejemplo, el intercepto es significativo al 5 %, mientras que el coeficiente asociado al SP500 presenta evidencia de significación al 10 %, pero no al 5 %. Por su parte, el coeficiente asociado al EuroStoxx 50 es altamente significativo, ya que su p-valor es inferior al 0,1 %.
:::
### Contraste de significación global
El contraste de significación global permite determinar si, consideradas conjuntamente, las variables explicativas del modelo aportan información estadísticamente significativa para explicar la variable dependiente. Por tanto, responde a una pregunta diferente de la planteada en el contraste de significación individual. Mientras que el contraste (t) permite analizar si una variable concreta es significativa, el contraste global permite determinar si el conjunto de variables explicativas, tomado en su totalidad, tiene capacidad explicativa.
La hipótesis nula plantea que ninguno de los coeficientes asociados a las variables explicativas es diferente de cero:
$$
H_{0}: \beta_{2} = \beta_{3} = \cdots = \beta_{k} = 0, \quad
H_{1}: \exists \, \beta_{i} \neq 0
$$
Es importante observar que la hipótesis alternativa no afirma que todos los coeficientes sean diferentes de cero. Únicamente establece que existe al menos uno que presenta un efecto estadísticamente distinto de cero.
Este contraste es un caso particular del contraste general de restricciones lineales (H$_0\beta$=r), en el que se imponen simultáneamente ($k-1$) restricciones sobre los coeficientes de las variables explicativas. Al sustituir estas restricciones en el estadístico general se obtiene el conocido estadístico (F) de significación global:
$$
F_{exp} = \frac{\frac{SCE}{k-1}}{\frac{SCR}{n-k}}
$$
donde $SCE$ es la suma de cuadrados explicada y $SCR$ la suma de cuadrados de los residuos.
El estadístico compara la variabilidad explicada por el modelo con la variabilidad que permanece sin explicar. Si el modelo no aporta capacidad explicativa, ambas cantidades serán relativamente similares y el estadístico (F) tomará un valor reducido. Por el contrario, si las variables explicativas permiten explicar una parte importante de la variabilidad de la variable dependiente, el numerador será grande en relación con el denominador y el estadístico (F) tomará un valor elevado.
Por tanto, para un nivel de significación ($\alpha$), la regla de decisión es:
$$F_{exp}> F_{k-1,n-k}(1-\alpha)$$
Si el estadístico experimental supera el valor crítico, existe evidencia suficiente para rechazar la hipótesis de que todos los coeficientes de las variables explicativas son simultáneamente iguales a cero. En consecuencia, se concluye que el modelo es globalmente significativo.
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
Al utilizar la función summary() sobre un modelo estimado mediante lm(), R proporciona directamente el estadístico (F) del contraste de significación global, junto con sus grados de libertad y el p-valor asociado. En este caso $F_{exp}=91.54$ y el p valor toma un valor proximo a cero ($2.2\times10^{-16}$)
```{r}
datos <- read_excel("data/BD_IBEX.xlsx", sheet = "Datos")
modeloIBEX <- lm(
    Rend_IBEX ~ Rend_SP500+ Rend_EUROSTOXX50,
    data = datos
)
summary(modeloIBEX)
```
Por tanto, esta información permite plantear directamente el contraste:
$$
H_0:\beta_2=\beta_3=\cdots=\beta_k=0
$$
frente a
$$
H_1:\text{al menos uno de los coeficientes es diferente de cero}.
$$
Así, si el p-valor asociado al estadístico (F) es inferior al 5 %, concluiremos que el modelo es globalmente significativo al 5 %.
:::
#### La tabla ANOVA {.unnumbered}
El contraste global puede interpretarse a partir de la descomposición de la variabilidad de la variable dependiente. Cuando el modelo incluye término independiente, la suma de cuadrados total puede descomponerse como $SCT=SCE+SCR$. La primera parte corresponde a la variabilidad explicada por el modelo y la segunda a la variabilidad que permanece en los residuos. La tabla ANOVA resume esta descomposición:
| Fuente de variación | Suma de cuadrados | Gl | Medias cuadráticas |
|-------------------|------------------|------------------|-------------------|
| Explicada | $SCE = \widehat{\beta}^t X^t y - n \overline{Y}^2$ | $k-1$ | $SCE/(k-1)$ |
| Residuos | $SCR = y^t y - \widehat{\beta}^t X^t y$ | $n-k$ | $SCR/(n-k)$ |
| Total | $SCT = y^t y - n \overline{Y}^2$ | $n-1$ | |
El estadístico (F) se obtiene, por tanto, como el cociente entre la media cuadrática explicada y la media cuadrática residual:
$$
\frac{SCE/(k-1)}
{SCR/(n-k)}.
$$
#### Relación con el coeficiente de determinación {.unnumbered}
Teniendo en cuenta que $R^2=\frac{SCE}{SCT}$, otra forma equivalente de expresar la región de rechazo es:
$$
\frac{\frac{R^{2}}{k-1}}{\frac{1 - R^{2}}{n-k}} > F_{k-1,n-k}(1-\alpha)
$$
Esta expresión permite establecer una conexión entre dos conceptos que hasta ahora se han presentado por separado. El ($R^2$) mide qué proporción de la variabilidad de la variable dependiente es explicada por el modelo, mientras que el contraste (F) permite determinar si esa capacidad explicativa es estadísticamente significativa.
Por tanto, un ($R^2$) elevado no implica automáticamente que el modelo sea estadísticamente significativo, ni un ($R^2$) reducido implica necesariamente que el modelo no sea significativo. La significación global depende también del tamaño de la muestra y del número de variables incluidas en el modelo.
### Estimador de mínimos cuadrados restringidos
El contraste general de hipótesis permite determinar si un conjunto de restricciones lineales sobre los parámetros del modelo es compatible con la información contenida en la muestra. Si no se rechaza la hipótesis nula $H_0: R\beta=r$, podemos considerar razonable incorporar dichas restricciones al proceso de estimación. En este caso, en lugar de estimar los parámetros únicamente mediante mínimos cuadrados ordinarios (MCO), podemos utilizar el estimador de mínimos cuadrados restringidos (MCR).
La idea es sencilla: mientras que los MCO buscan los valores de los parámetros que minimizan la suma de cuadrados de los residuos sin imponer restricciones adicionales, los mínimos cuadrados restringidos buscan los valores que minimizan dicha suma de cuadrados entre aquellos que cumplen las restricciones planteadas.
El estimador de mínimos cuadrados restringidos viene dado por:
$$
\widehat{\beta}_{R} = \widehat{\beta} + (X^tX)^{-1} R^t
\left[ R (X^tX)^{-1} R^t \right]^{-1} \cdot (r - R \widehat{\beta})
$$
Cuando las restricciones son ciertas, el estimador restringido presenta algunas propiedades interesantes. Es un estimador lineal e insesgado y, además, tiene una varianza menor o igual que la del estimador MCO. La incorporación de información válida sobre los parámetros permite, por tanto, obtener estimaciones más precisas.
Sin embargo, esta mejora tiene un coste: al imponer restricciones, estamos limitando el conjunto de valores posibles de los parámetros. Por ello, la suma de cuadrados de los residuos del modelo restringido nunca puede ser inferior a la del modelo no restringido:
$$
SCR_R\geq SCR.
$$
En consecuencia, cuando el modelo incluye término independiente:
$$
R_R^2\leq R^2.
$$
Es decir, imponer restricciones no puede mejorar el ajuste del modelo en términos de (R^2). Esto no significa que el modelo restringido sea peor. Si las restricciones son correctas, podemos aceptar una pequeña pérdida de ajuste a cambio de obtener estimaciones con menor varianza.
Por tanto, es importante distinguir entre dos preguntas:
- ¿Son compatibles las restricciones con los datos? Esta es la pregunta que responde el contraste general (F).
- ¿Qué estimaciones obtenemos si imponemos dichas restricciones? Esta es la pregunta que responde el estimador de mínimos cuadrados restringidos.
En este sentido, el contraste general constituye un paso previo fundamental para decidir si tiene sentido incorporar las restricciones al modelo.
Una vez presentados los estimadores MCR, se puede reformular el contraste general para realizarse fácilmente sin necesidad de construir explícitamente la matriz (R) y el vector (r). Para ello, en R usamos la función `linearHypothesis()` del paquete `car` que permite especificar directamente las restricciones que queremos contrastar y proporciona el contraste (F), sus grados de libertad y el p-valor asociado.
La lógica del contraste consiste en comparar el ajuste del modelo restringido con el del modelo no restringido (o modelo original). Al introducir restricciones, el modelo restringido dispone de un conjunto menor de valores posibles para los parámetros y, por tanto, su suma de cuadrados de los residuos no puede ser menor que la del modelo no restringido. La cuestión que plantea el contraste es, por tanto, si el aumento de la suma de cuadrados de los residuos que se produce al imponer las restricciones es suficientemente pequeño como para considerar que dichas restricciones son compatibles con los datos, o, por el contrario, si dicho aumento es demasiado elevado como para mantenerlas.
De esta forma, el estadístico experimental del contraste general se puede reescribir como:
$$F=\frac{\frac{SCR_R-SCR}{q}}{\frac{SCR}{n-k}}$$
donde:
- $SCR_R-SCR$ mide cuánto empeora el ajuste al imponer las restricciones;
- $q$ es el número de restricciones;
- $SCR/(n−k)$ es la estimación de la varianza de la perturbación en el modelo no restringido.
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
Partiendo del modelo:
ROA_i=\beta_0+\beta_1LEV_i+\beta_2LIQ_i+u_i
para contrastar conjuntamente $ \beta_1=0$ y $ \beta_1-\beta_2=0$ se puede usar la función `linearHypothesis` del paquete `car` que no exige construir la matriz de restricciones ni resultados.
```{r}
linearHypothesis(modelo,
                 c("ENDEUDAMIENTO = 0",
                   "ENDEUDAMIENTO-LIQUIDEZ_INMEDIATA = 0"))
```
:::
## Explotación del modelo
Una vez estimado y validado el modelo, podemos utilizarlo para **explotar la información que proporciona**. En esta fase, el modelo deja de utilizarse únicamente para analizar las relaciones existentes entre las variables y pasa a emplearse para obtener resultados sobre situaciones concretas.
Entre las principales aplicaciones se encuentran la **predicción** de la variable dependiente para determinados valores de las variables explicativas y el análisis de la **permanencia estructural** del modelo, que permitirá comprobar si las relaciones estimadas se mantienen cuando cambia el periodo, el grupo de empresas o las condiciones económicas.
### Predicción
La predicción permite utilizar el modelo estimado para obtener un valor de la variable dependiente cuando conocemos los valores que toman las variables explicativas. Esta predicción puede referirse al **valor esperado de la variable dependiente** o a una **realización individual** de dicha variable.
Supongamos que queremos realizar una predicción para una nueva observación cuyos valores de las variables explicativas vienen recogidos en el vector:
$$
x_0^t=(1,X_{02},X_{03},\dots,X_{0k}).
$$
A partir del modelo estimado:
$$
\widehat{Y}=X\widehat{\beta},
$$
podemos obtener una predicción puntual mediante:
$$
\widehat{Y}_0=x_0^t\widehat{\beta}.
$$
Esta expresión permite obtener tanto una estimación puntual del valor esperado de (Y_0) condicionado a (x_0),
$$
\widehat{E(Y_0|x_0)}=x_0^t\widehat{\beta},
$$
como una predicción puntual de una futura realización de (Y_0).
La diferencia entre ambas situaciones será importante cuando construyamos intervalos. En el primer caso queremos conocer **dónde se encuentra el valor medio esperado de (Y)** para unas determinadas características, mientras que en el segundo queremos determinar **en qué intervalo podría encontrarse una observación individual**.
### Predicción mediante intervalos
La predicción puntual proporciona un único valor, pero no informa sobre la incertidumbre asociada a dicha predicción. Dado que los parámetros del modelo son estimados a partir de una muestra y que existe una perturbación aleatoria, la predicción está sujeta a incertidumbre.
Por ello, resulta conveniente acompañar la predicción puntual de un intervalo. Es necesario distinguir dos situaciones:
- **Intervalo de confianza para el valor esperado de (Y)**: proporciona un intervalo para (E(Y_0|x_0)), es decir, para el valor medio de la variable dependiente cuando las variables explicativas toman los valores (x_0).
- **Intervalo de predicción para una observación individual de (Y)**: proporciona un intervalo en el que esperamos encontrar una realización concreta de (Y_0).
El intervalo de confianza para el valor esperado de (Y) viene dado por:
$$
x_0^t\widehat{\beta}
\pm
t_{n-k}\left(1-\frac{\alpha}{2}\right)
\widehat{\sigma}
\sqrt{x_0^t(X^tX)^{-1}x_0}.
$$
Por su parte, el intervalo de predicción para una observación individual de (Y) es:
$$
x_0^t\widehat{\beta}
\pm
t_{n-k}\left(1-\frac{\alpha}{2}\right)
\widehat{\sigma}
\sqrt{
1+x_0^t(X^tX)^{-1}x_0
}.
$$
La diferencia entre ambos intervalos se encuentra en el término (1) que aparece en el intervalo de predicción para una observación individual. Este término recoge la **incertidumbre asociada a la perturbación aleatoria de la nueva observación**. Por este motivo, el intervalo de predicción es siempre más amplio que el intervalo de confianza para el valor esperado, manteniendo el mismo nivel de confianza.
En términos intuitivos, el intervalo de confianza responde a la pregunta:
> **¿Entre qué valores se encuentra el valor medio esperado de (Y) para unas determinadas características?**
Mientras que el intervalo de predicción responde a:
> **¿Entre qué valores puede encontrarse una nueva observación individual de (Y) con esas características?**
::: {.callout-note appearance="simple" icon=false title="Base de datos 1: Top 100 empresas andaluzas del transporte"}
La distinción entre la predicción para el valor individual o para el valor esperado, resulta especialmente relevante en aplicaciones financieras y contables. Por ejemplo, para el modelo que explica el **ROA** de un conjunto de empresas a partir de su endeudamiento y liquidez, podemos utilizarlo para estimar el ROA medio esperado para empresas con unas determinadas características o, alternativamente, para predecir el ROA de una empresa concreta.
En R, ambas predicciones pueden obtenerse directamente mediante la función `predict()`. Por ejemplo, suponemos una empresa nueva con un ENDEUDAMIENTO de 15 y una LIQUIDEZ_INMEDIATA DE 3
```{r}
nueva_empresa <- data.frame(
  ENDEUDAMIENTO = 15,
  LIQUIDEZ_INMEDIATA = 3
)
```
Se puede obtener la predicción por intervalo del valor individual:
```{r}
predict(
  modelo,
  newdata = nueva_empresa,
  interval = "confidence"
)
```
o el intervalo de confianza para el valor esperado:
```{r}
predict(
  modelo,
  newdata = nueva_empresa,
  interval = "prediction"
)
```
La amplitud de ambos intervalos depende del nivel de confianza elegido y de la incertidumbre asociada a la estimación. En particular, las predicciones serán generalmente más precisas para valores de las variables explicativas próximos a los observados en la muestra y menos precisas cuando se realizan para características alejadas de las utilizadas para estimar el modelo.
:::
### Permanencia estructural
Otra de las aplicaciones del modelo estimado consiste en analizar su permanencia estructural, es decir, comprobar si la relación entre la variable dependiente y las variables explicativas se mantiene estable cuando cambia el periodo de análisis o el grupo de observaciones considerado.
Al utilizar el modelo para realizar predicciones sobre observaciones que no pertenecen a la muestra utilizada para su estimación, estamos suponiendo implícitamente que la relación estimada se mantiene. Por ejemplo, si estimamos una relación entre el rendimiento del IBEX 35 y los rendimientos del SP500 y del EuroStoxx 50 para un determinado periodo, estamos suponiendo que los coeficientes estimados siguen siendo válidos para otro periodo.
La cuestión que se plantea es, por tanto, si los parámetros del modelo son estables o, por el contrario, existe evidencia de que la relación entre las variables ha cambiado.
Una primera aproximación intuitiva consiste en comparar las predicciones realizadas por el modelo con los valores observados fuera de la muestra. Así, para una nueva observación caracterizada por ($x_0$), podemos obtener una predicción y su correspondiente intervalo de predicción. Si el valor observado se sitúa dentro del intervalo para $Y$ dado $x_0$, se dice que los resultados son compatibles con el comportamiento previsto por el modelo. Sin embargo, esta comprobación debe interpretarse con cautela: que una observación individual se encuentre dentro del intervalo no constituye, por sí mismo, un contraste formal de permanencia estructural, es solo una primera idea intuitiva.
#### Test de Chow {.unnumbered}
Para analizar formalmente si los parámetros se mantienen constantes entre dos grupos de observaciones, podemos comparar el modelo estimado sobre el conjunto de datos con los modelos estimados separadamente para cada grupo.
Supongamos, por ejemplo, que disponemos de información sobre empresas correspondiente a dos periodos y queremos comprobar si la relación entre ROA, endeudamiento y liquidez es la misma en ambos periodos. La hipótesis nula de permanencia estructural sería:
$$
H_0:
\beta_{0}^{(1)}=\beta_{0}^{(2)},\quad
\beta_{1}^{(1)}=\beta_{1}^{(2)},\quad
\ldots,\quad
\beta_{k-1}^{(1)}=\beta_{k-1}^{(2)}.
$$
Frente a la alternativa:
$$
H_1:\text{al menos uno de los parámetros es diferente}.
$$
Una forma de realizar este contraste, cuando los grupos están definidos a priori, es mediante el contraste de Chow. La lógica del contraste es comparar la suma de cuadrados de los residuos del modelo restringido, en el que se supone que los parámetros son iguales para los dos grupos, con la suma de cuadrados de los residuos de los modelos no restringidos, en los que cada grupo tiene sus propios parámetros.
Si denominamos (SCR_P) a la suma de cuadrados de los residuos del modelo restringido o conjunto y (SCR_1) y (SCR_2) a las correspondientes a los modelos estimados por separado, el estadístico de Chow es:
$$
F=
\frac{
\left[
SCR_P-(SCR_1+SCR_2)
\right]/k
}{
(SCR_1+SCR_2)/(n_1+n_2-2k)
}.
$$
El numerador mide cuánto empeora el ajuste cuando obligamos a que los dos grupos compartan los mismos parámetros. Si la diferencia entre el ajuste restringido y el no restringido es pequeña, no tendremos evidencia suficiente para rechazar la permanencia estructural. Si, por el contrario, la imposición de unos mismos parámetros provoca un aumento importante de la suma de cuadrados de los residuos, tendremos evidencia de un cambio estructural.
La hipótesis nula se rechaza cuando el estadístico experimental supera el valor crítico de la distribución (F) correspondiente o, de forma equivalente, cuando su p-valor es inferior al nivel de significación elegido. En ese caso, concluiremos que existen evidencias de que los parámetros no son estables entre los dos grupos analizados.
::: {.callout-tip appearance="simple" icon=false title="Base de datos 2: El IBEX35"}
Por ejemplo, podemos comprobar si la relación entre el IBEX, el SP500 y el EuroStoxx 50 se mantiene entre los primeros 36 y los últimos 36 meses:
```{r}
modeloIBEX <- lm(
  Rend_IBEX ~ Rend_SP500 + Rend_EUROSTOXX50,
  data = datos
)

sctest(
  modeloIBEX,
  type = "Chow",
  point = 36
)
```
Como el p valor es igual a 0.2586, no podemos rechazar la hipótesis nula de que los parámetros son iguales entre los primeros y los ultimos 36 meses al 90%, 95% y 99% de confianza.
:::
El análisis anterior se ha planteado para series temporales, donde la permanencia estructural permite comprobar si los parámetros del modelo se mantienen estables a lo largo del tiempo. El test de Chow resulta especialmente apropiado cuando existe un punto de ruptura conocido que permite dividir la muestra temporal en dos periodos.
En el caso de datos transversales, la lógica es similar, aunque no existe una dimensión temporal que permita dividir la muestra en periodos. En este caso, puede ser de interés comprobar si la relación estimada es la misma para distintos grupos de individuos o empresas. Por ejemplo, podríamos preguntarnos si el modelo que explica el ROA presenta los mismos parámetros para empresas grandes y pequeñas, para empresas pertenecientes a distintos sectores o para empresas con diferentes características financieras.
Para ello, se pueden estimar modelos que permitan que los parámetros varíen entre los grupos y plantear posteriormente un contraste general de restricciones lineales.
## Prácticas resueltas
### Obtención de los estimadores mediante el sumatorio de las variables {-}
A partir de los datos del modelo de la rentabilidad, se tienen los siguientes sumatorios:
$$\sum ROA_i=768,54; \sum LEV_i=6379,76;\sum LIQ_i=34.707$$
$$\sum LEV_i^2=461145,61;\sum LIQ_i^2=38.468; \sum LEV_i\times LIQ_i=1353,61$$
$$\sum ROA_i \times LEV_i=41060,34; \sum ROA_i \times LIQ_i=389,47; \sum ROA_i^1=10.456,08$$
Con estos datos se pueden construir las siguientes matrices:
$$X^{t} X = \left(
\begin{array}{cccc}
100 & 6379,76 & 34,707 \\
6379,76 & 461145,61 & 1353,61 \\
34,707 & 1353,61 & 38,468 \\
\end{array} \right),$$
\noindent y
$$(X^{t} X)^{-1} = \left(
\begin{array}{cccc}
0,23066 &-0,00288& -0,10686\\
-0,00288& 0,00004& 0,00125\\
-0,10686& 0,00125& 0,07849\\
\end{array} \right),$$
\noindent
$$X^{t} y = \left(
\begin{array}{c}
768,54 \\
41060,34\\
389,47\\
\end{array} \right).$$
Se puede calcular la inversa de la matriz $X'X$ y se obtendrán los siguientes estimadores que coinciden con los obtenidos mediante la función `lm`.
$$\hat{\beta} = \left(
\begin{array}{c}
17,5053 \\
-0,1522\\
-0,3133\\
\end{array} \right).$$
### Función de producción. Importancia de una buena especificación. {.unnumbered}
Vamos a trabajar con la base de datos de @Greene2003 denominada `BD_FUNCIONPRODUCCION' para realizar una práctica cuyo objetivo es introducir la estimación en R y comprender la importancia de realizar una adecuada especificación del modelo econométrico.
```{r}
datos= read_excel('data/BD_FUNCIONPRODUCCION.xlsx')
```
Esta base de datos procede del estudio de Solow (1957) en relación con la función de producción. Contamos con información sobre la producción agregada por trabajador/hora (q), un ratio sobre el capital agregado/trabajo (k) y un índice tecnológico (A).
Se pide:
1. **Obtener los estadísticos descriptivos básicos:**
Para ello se usa la función *summary*:
```{r}
summary(datos)
```
2. **Obtener la matriz de correlaciones:**
Para ello, se usa la función *cor*:
```{r}
cor(datos)
```
3. **Representar un gráfico de la nube de puntos entre cada una de las variables explicativas y la explicada:**
```{r, grafico 1, fig.width=4, fig.height=3}
ggplot(datos, aes(x = k, y = q)) +
  geom_point(color = "blue") +
  labs(title = "q vs k", x = "k", y = "q") +
  theme_minimal()
```
```{r, grafico 2, fig.width=4, fig.height=3}
ggplot(datos, aes(x = A, y = q)) +
  geom_point(color = "red") +
  labs(title = "q vs A", x = "A", y = "q") +
  theme_minimal()
```
4. **Estimar el modelo que explique la producción agregada por trabajador/hora** en función del ratio sobre el capital agregado/trabajo ($k$) y el índice tecnológico ($A$), es decir: $$q_t=\beta_1+\beta_2k_t+\beta_3A_t+u_t$$.
Para estimar dicho modelo usamos la función *lm*. Se puede obtener los principales resultados de la estimación mediante la función *summary*:
```{r}
modelo1=lm(q~k+A, data=datos)
summary(modelo1)
```
Así, se observa que el modelo estimado tiene la siguiente expresión: $$\hat{q}_t=-0.295445+0.0956250k_t+0.717229A_t$$
5. **Interprete los coeficiente estimados:**
- El termino independiente (-0.295445) representa el valor esperado de producción agregada por trabajador/hora ($q$) cuando tanto el capital agregado por trabajador ($k$) como el índice tecnológico ($A$) toman el valor 0. En este contexto económico, un capital agregado nulo y un índice tecnológico nulo no son realistas, así que el término independiente no tiene una interpretación económica directa, sino que sirve como punto de referencia para la ecuación de regresión.
- El estimador asociado a la variable $k$ tiene la siguiente interpretación: un aumento de 1 unidad en el capital por trabajador se asocia con un aumento promedio de 0.0956 unidades en la producción por trabajador/hora, manteniendo A constante.
- El estimador asociado a la variable $A$ tiene la siguiente interpretación: un aumento de 1 unidad en el índice tecnológico se asocia con un aumento promedio de 0.7172 unidades en la producción por trabajador/hora, manteniendo $k$ constante.
Se observa que el efecto de la tecnología sobre la productividad es mucho mayor que el efecto del capital. Esto resalta la importancia de la tecnología como motor del crecimiento en la función de producción, lo que esta relacionado con los trabajos premiados con el Nobel de Economía en el año 2025. Véase <https://www.nobelprize.org/uploads/2025/10/press-economicsciences2025-1.pdf>
6. **Representa graficamente los residuos de la estimación anterior:**
Para ello, vamos a guardar los residuos de dicha estimación y a representarlos graficamente:
```{r}
residuos1=resid(modelo1)
plot(datos$year, residuos1, type = "l", col = "blue", lwd = 2,
     xlab = "Año", ylab = "Residuos modelo 1",
     main = "Residuos de la regresión q ~ k + A")
```
Del modelo se pueden extraer tambien los valores estimados:
```{r}
q_estimada_modelo1<- fitted(modelo1)
```
```{r}
df <- data.frame(
  año = rep(datos$year, 2),
  valor = c(q_estimada_modelo1, datos$q),
 variable = rep(c("Variable estimada", "Variable observada"), each = nrow(datos))
)

ggplot(df, aes(x = año, y = valor, color = variable)) +
  geom_line(linewidth = 1) +
  labs(title = "Variable estimada vs observada", x = "Año", y = "Valor") +
  theme_minimal()
```
7. **Repite el análisis anterior, pero sin incorporar la variable indice tecnológico, que se ha comprobado que es una variable especialmente relevante en el modelo:**
```{r}
modelo2=lm(q~k, data=datos)
summary(modelo2)
```
A continuación, representamos los residuos del modelo junto con la variable $A$ que recordemos que no ha sido incluida en el modelo:
```{r}
residuos2=resid(modelo2)
df <- data.frame(
  año = rep(datos$year, 2),
  valor = c(residuos2, datos$A),
 variable = rep(c("Residuos", "A"), each = nrow(datos))
)

ggplot(df, aes(x = año, y = valor, color = variable)) +
  geom_line(linewidth = 1) +
  labs(title = "Residuos de q~k y variable A", x = "Año", y = "Valor") +
  theme_minimal()
```
**¿Encuentras algún patrón de comportamiento en los residuos? ¿A qué crees que puede deberse?**
### Obtención de los estimadores mediante el sumatorio de las variables {-}
Se dispone de una muestra de $n=8$ auditores. Para cada uno de ellos se conoce:
- $Y$: la nota obtenida en el examen a auditor.
- $X_1$: las horas de estudio dedicadas.
- $X_2$: la planta del edificio en la que vive el auditor.
La variable $X_2$ no guarda ninguna relación causal con la nota obtenida: se incluye únicamente con fines didácticos, para comprobar qué ocurre con la bondad del ajuste cuando se incorpora al modelo una variable explicativa sin sentido económico. Los datos de partida son los siguientes:
| Auditor | $Y$ | $X_1$ | $X_2$ |
|:------:|:---:|:-----:|:-----:|
| 1 | 3.0 | 2 | 0 |
| 2 | 4.5 | 3 | 1 |
| 3 | 5.0 | 5 | 0 |
| 4 | 6.5 | 6 | 2 |
| 5 | 7.0 | 7 | 1 |
| 6 | 8.0 | 8 | 0 |
| 7 | 9.0 | 10 | 3 |
| 8 | 9.5 | 11 | 1 |
El ejercicio se resuelve **sin código de R**, obteniendo a mano, a partir de los sumatorios, todas las matrices y operaciones necesarias para estimar el modelo por mínimos cuadrados ordinarios y calcular su bondad del ajuste.
Vamos a estimar dos modelos: uno con las dos variables explicativas ($X_1$ y $X_2$) y otro eliminando la variable "absurda" ($X_2$), para comparar su $R^2$ y su $R^2$ corregido.
**Modelo 1: especificación completa**\\
$$Y_i=\beta_1+\beta_2X_{1i}+\beta_3X_{2i}+u_i$$
A partir de los datos de partida se obtienen las siguientes columnas auxiliares:
| $Y$ | $X_1$ | $X_2$ | $X_1^2$ | $X_2^2$ | $X_1X_2$ | $X_1Y$ | $X_2Y$ | $Y^2$ |
|:---:|:---:|:---:|:---:|:---:|:---:|:---:|:---:|:---:|
| 3.0 | 2 | 0 | 4 | 0 | 0 | 6.0 | 0.0 | 9.00 |
| 4.5 | 3 | 1 | 9 | 1 | 3 | 13.5 | 4.5 | 20.25 |
| 5.0 | 5 | 0 | 25 | 0 | 0 | 25.0 | 0.0 | 25.00 |
| 6.5 | 6 | 2 | 36 | 4 | 12 | 39.0 | 13.0 | 42.25 |
| 7.0 | 7 | 1 | 49 | 1 | 7 | 49.0 | 7.0 | 49.00 |
| 8.0 | 8 | 0 | 64 | 0 | 0 | 64.0 | 0.0 | 64.00 |
| 9.0 | 10 | 3 | 100 | 9 | 30 | 90.0 | 27.0 | 81.00 |
| 9.5 | 11 | 1 | 121 | 1 | 11 | 104.5 | 9.5 | 90.25 |
| **$\sum$ = 52.5** | **$\sum$ = 52** | **$\sum$ = 8** | **$\sum$ = 408** | **$\sum$ = 16** | **$\sum$ = 63** | **$\sum$ = 391** | **$\sum$ = 61** | **$\sum$ = 380.75** |
Con $n=8$, resumimos las magnitudes necesarias:
$$
n=8 \quad \sum Y_i=52.5 \quad \sum X_{1i}=52 \quad \sum X_{2i}=8
$$
$$
\sum X_{1i}^2=408 \quad \sum X_{2i}^2=16 \quad \sum X_{1i}X_{2i}=63
$$
$$
\sum X_{1i}Y_i=391 \quad \sum X_{2i}Y_i=61 \quad \sum Y_i^2=380.75
$$
Obtenemos las matrices $X^tX$ y $X^ty$:
$$
X^tX=\begin{bmatrix} n & \sum X_{1i} & \sum X_{2i}\\ \sum X_{1i} & \sum X_{1i}^2 & \sum X_{1i}X_{2i}\\ \sum X_{2i} & \sum X_{1i}X_{2i} & \sum X_{2i}^2 \end{bmatrix}=\begin{bmatrix} 8 & 52 & 8\\ 52 & 408 & 63\\ 8 & 63 & 16 \end{bmatrix}
$$
$$
X^ty=\begin{bmatrix} \sum Y_i\\ \sum X_{1i}Y_i\\ \sum X_{2i}Y_i \end{bmatrix}=\begin{bmatrix} 52.5\\ 391\\ 61 \end{bmatrix}
$$
Para obtener la inversa, calculamos primero el determinante desarrollando por la primera fila. Los adjuntos (cofactores) que necesitamos son:
$$
C_{11}=\begin{vmatrix}408 & 63\\63 & 16\end{vmatrix}=408\cdot16-63\cdot63=6528-3969=2559
$$
$$
C_{12}=-\begin{vmatrix}52 & 63\\8 & 16\end{vmatrix}=-(52\cdot16-63\cdot8)=-(832-504)=-328
$$
$$
C_{13}=\begin{vmatrix}52 & 408\\8 & 63\end{vmatrix}=52\cdot63-408\cdot8=3276-3264=12
$$
$$
|X^tX|=8\cdot C_{11}+52\cdot C_{12}+8\cdot C_{13}=8(2559)+52(-328)+8(12)$$
$$
=20472-17056+96=3512
$$
Procediendo del mismo modo con el resto de filas y columnas se obtiene la matriz completa de adjuntos (que, al ser $X^tX$ simétrica, resulta también simétrica):
$$
\text{Adj}(X^tX)=\begin{bmatrix} 2559 & -328 & 12\\ -328 & 64 & -88\\ 12 & -88 & 560 \end{bmatrix}
$$
Por tanto:
$$
(X^tX)^{-1}=\frac{1}{|X^tX|}\,\text{Adj}(X^tX)^t=\frac{1}{3512}\begin{bmatrix} 2559 & -328 & 12\\ -328 & 64 & -88\\ 12 & -88 & 560 \end{bmatrix}=
$$
$$
\begin{bmatrix} 0.728645 & -0.093394 & 0.003417\\ -0.093394 & 0.018223 & -0.025057\\ 0.003417 & -0.025057 & 0.159453 \end{bmatrix}
$$
Para obtener los estimadores $\widehat{\beta}=(X^tX)^{-1}X^ty$, multiplicamos cada fila de $(X^tX)^{-1}$ por el vector $X^ty$:
$$
\widehat{\beta}_1=0.728645(52.5)-0.093394(391)+0.003417(61)
$$
$$
=38.253844-36.517084+0.208428=1.945188
$$
$$
\widehat{\beta}_2=-0.093394(52.5)+0.018223(391)-0.025057(61)=
$$
$$
-4.903189+7.125285-1.528474=0.693622
$$
$$
\widehat{\beta}_3=0.003417(52.5)-0.025057(391)+0.159453(61)=
$$
$$
0.179385-9.797267+9.726651=0.108770
$$
Por lo que finalmente, el modelo estimado queda:
$$
\widehat{Y}_i=1.945188+0.693622\,X_{1i}+0.108770\,X_{2i}
$$
Se pueden obtener los valores estimados y los residuos:
| $Y$ | $\widehat{Y}$ | $e=Y-\widehat{Y}$ | $e^2$ |
|:---:|:---:|:---:|:---:|
| 3.0 | 3.332432 | -0.332432 | 0.110511 |
| 4.5 | 4.134823 | 0.365177 | 0.133354 |
| 5.0 | 5.413297 | -0.413297 | 0.170815 |
| 6.5 | 6.324459 | 0.175541 | 0.030815 |
| 7.0 | 6.909311 | 0.090689 | 0.008225 |
| 8.0 | 7.494163 | 0.505837 | 0.255871 |
| 9.0 | 9.207716 | -0.207716 | 0.043146 |
| 9.5 | 9.683798 | -0.183798 | 0.033782 |
| 52.5 | **$\sum$ = 52.5** | **$\sum \approx 0$** | **$\sum$ = 0.786519** |
A continuación, calculamos la suma de cuadrados:
$$
SCT=y^ty-n\overline{Y}^2=380.75-8(6.5625)^2=380.75-344.53125=36.21875
$$
$$
SCE=\widehat{\beta}^tX^ty-n\overline{Y}^2=\big[1.945188(52.5)+0.693622(391)+0.108770(61)\big]-344.53125=$$
$$
379.963482-344.53125=35.432232
$$
$$
SCR=SCT-SCE=36.21875-35.432232=0.786518
$$
(obsérvese que $SCR$ coincide, salvo redondeo, con $\sum e^2=0.786519$ calculado en la tabla anterior).
$$
R^2=\frac{SCE}{SCT}=\frac{35.432232}{36.21875}=0.978284
$$
Para el $R^2$ corregido, con $k=3$ parámetros estimados ($\widehat{\beta}_1,\widehat{\beta}_2,\widehat{\beta}_3$):
$$
\overline{R}^2=1-(1-R^2)\frac{n-1}{n-k}=1-(1-0.978284)\frac{7}{5}=1-0.021716(1.4)=0.969598
$$
**Modelo 2: eliminando la variable absurda ($X_2$)**\\
Vamos a estimar ahora el siguiente modelo:
$$Y_i=\beta_1+\beta_2X_{1i}+u_i$$
Reutilizamos las magnitudes ya calculadas que involucran únicamente a $Y$ y $X_1$:
$$
n=8 \quad \sum Y_i=52.5 \quad \sum X_{1i}=52 \quad \sum X_{1i}^2=408 \quad \sum X_{1i}Y_i=391 \quad \sum Y_i^2=380.75
$$
Se obtienen las matrices $X^tX$ y $X^ty$:
$$
X^tX=\begin{bmatrix} n & \sum X_{1i}\\ \sum X_{1i} & \sum X_{1i}^2 \end{bmatrix}=\begin{bmatrix} 8 & 52\\ 52 & 408 \end{bmatrix} \qquad X^ty=\begin{bmatrix} \sum Y_i\\ \sum X_{1i}Y_i \end{bmatrix}=\begin{bmatrix} 52.5\\ 391 \end{bmatrix}
$$
Se obtiene la inversa de $X^tX$ (matriz $2\times2$)
$$
|X^tX|=8(408)-52(52)=3264-2704=560
$$
$$
(X^tX)^{-1}=\frac{1}{560}\begin{bmatrix} 408 & -52\\ -52 & 8 \end{bmatrix}=\begin{bmatrix} 0.728571 & -0.092857\\ -0.092857 & 0.014286 \end{bmatrix}
$$
Y multiplicando se obtienen los estimadores:
$$
\widehat{\beta}_1=0.728571(52.5)-0.092857(391)=38.25-36.307143=1.942857
$$
$$
\widehat{\beta}_2=-0.092857(52.5)+0.014286(391)=-4.875+5.585714=0.710714
$$
Por lo que finalmente el modelo estimado queda:
$$
\widehat{Y}_i=1.942857+0.710714\,X_{1i}
$$
Y los valores estimados y los residuos se recogen en esta tabla:
| $Y$ | $\widehat{Y}$ | $e=Y-\widehat{Y}$ | $e^2$ |
|:---:|:---:|:---:|:---:|
| 3.0 | 3.364286 | -0.364286 | 0.132704 |
| 4.5 | 4.075000 | 0.425000 | 0.180625 |
| 5.0 | 5.496429 | -0.496429 | 0.246441 |
| 6.5 | 6.207143 | 0.292857 | 0.085765 |
| 7.0 | 6.917857 | 0.082143 | 0.006747 |
| 8.0 | 7.628571 | 0.371429 | 0.137959 |
| 9.0 | 9.050000 | -0.050000 | 0.002500 |
| 9.5 | 9.760714 | -0.260714 | 0.067972 |
| 52.5 | **$\sum$ = 52.5** | **$\sum \approx 0$** | **$\sum$ = 0.860713** |
Igual que en el caso anterior se pueden obtener la suma de cuadrados:
$$
SCT=380.75-344.53125=36.21875
$$
$$
SCE=\big[1.942857(52.5)+0.710714(391)\big]-344.53125=379.889286-344.53125
$$
$$
=35.358036
$$
$$
SCR=SCT-SCE=36.21875-35.358036=0.860714
$$
Y, a partir de ellas, el coeficiente de determinación ordinario y corregido:
$$
R^2=\frac{SCE}{SCT}=\frac{35.358036}{36.21875}=0.976236
$$
Con $k=2$ parámetros estimados ($\widehat{\beta}_1,\widehat{\beta}_2$):
$$
\overline{R}^2=1-(1-R^2)\frac{n-1}{n-k}=1-(1-0.976236)\frac{7}{6}=1-0.023764(1.1\overline{6})=0.972275
$$
**Comparación de los dos modelos**\\
La siguiente tabla compara ambos modelos:
| Modelo | Variables | $k$ | $R^2$ | $\overline{R}^2$ |
|:---|:---:|:---:|:---:|:---:|
| Modelo 1 (completo) | $X_1, X_2$ | 3 | 0.978284 | 0.969598 |
| Modelo 2 (reducido) | $X_1$ | 2 | 0.976236 | **0.972275** |
Al incorporar la variable $X_2$ (la planta en la que vive el auditor, sin ninguna relación causal con la nota) el $R^2$ aumenta ligeramente, de 0.976236 a 0.978284. Esto no debe sorprender: el $R^2$ ordinario nunca puede disminuir cuando se añade un regresor adicional al modelo, por muy irrelevante que sea, porque el ajuste por mínimos cuadrados siempre puede aprovechar cualquier variación adicional, aunque sea espuria.
Sin embargo, el $R^2$ corregido se comporta de forma justamente contraria: disminuye, de 0.972275 a 0.969598, al pasar del modelo reducido al modelo completo. Al penalizar la pérdida de un grado de libertad por cada parámetro adicional estimado, el $\overline{R}^2$ detecta que la variable $X_2$ no aporta suficiente capacidad explicativa para compensar el coste de incluirla en el modelo.
Esta discrepancia entre $R^2$ y $\overline{R}^2$ ilustra por qué no debe utilizarse el $R^2$ ordinario para comparar o seleccionar modelos con distinto número de regresores, y por qué el $R^2$ corregido —o, en su lugar, criterios como los de Akaike o Schwarz— constituye un criterio más adecuado para valorar si una variable adicional realmente mejora la especificación del modelo o simplemente lo sobrecarga sin justificación económica.
### Demanda de productos lacteos: Estimación y selección de modelos. Interpretación de coeficientes con logaritmos. {.unnumbered}
Partiendo de la base de datos de @Uriel2019 denominada $demand$, se han considerado los siguientes modelos alternativos para analizar los determinantes del gasto en productos lácteos $dairy$ en función de la renta disponible de los hogares $inc$, el número de miembros del hogar $hhsize$ y la proporción de niños menores de cinco años en el hogar $punder5$:
```{r}
demand= read_excel('data/bd3_demand.xlsx')
demand<-as.data.frame(demand)
```
Se proponen los siguientes modelos: - Modelo 1: $dairy=\beta_1+\beta_2inc+u$
- Modelo 2: $dairy=\beta_!+\beta_2ln(inc)+u$
- Modelo 3: $dairy=\beta_1+\beta_2inc+\beta_3punder5+u$
- Modelo 4: $dairy=\beta_2inc+\beta_3punder5+u$
- Modelo 5: $dairy=\beta_1+\beta_2inc+\beta_3hhsize+u$
- Modelo 6: $ln(dairy)=\beta_1+\beta_2inc+u$
- Modelo 7: $ln(dairy)=\beta_1+\beta_2inc+\beta_3punder5+u$
- Modelo 8: $ln(dairy)=\beta_2inc+\beta_3punder5+u$
Se pide estimar los distintos modelos y compararlos mediante en terminos de bondad del ajuste. Para ello, en primer lugar se estiman los modelos y se extraen del resumen de cada estiamción el coeficiente de determinación corregido, el criterio de Akaike y el BIC.
```{r}
modelo1=lm(DAIRY~INC, data=demand)
resultado_modelo1=summary(modelo1)
modelo2=lm(DAIRY~log(INC), data=demand)
resultado_modelo2=summary(modelo2)
modelo3=lm(DAIRY~INC+PUNDER5, data=demand)
resultado_modelo3=summary(modelo3)
modelo4=lm(DAIRY~INC+PUNDER5-1, data=demand)
resultado_modelo4=summary(modelo4)
modelo5=lm(DAIRY~INC+HHSIZE, data=demand)
resultado_modelo5=summary(modelo5)
modelo6=lm(log(DAIRY)~INC,data=demand)
resultado_modelo6=summary(modelo6)
modelo7=lm(log(DAIRY)~INC+PUNDER5,data=demand)
resultado_modelo7=summary(modelo7)
modelo8=lm(log(DAIRY)~INC+PUNDER5-1,data=demand)
resultado_modelo8=summary(modelo8)
```
```{r}
resultados <- data.frame(
Modelo = c("modelo1", "modelo2","modelo3","modelo4","modelo5","modelo6","modelo7","modelo8"),
DF     = c(length(coef(modelo1)), length(coef(modelo2)), length(coef(modelo3)), length(coef(modelo4)), length(coef(modelo5)), length(coef(modelo6)), length(coef(modelo7)), length(coef(modelo8))),
R2_CORREGIDO = c(resultado_modelo1$adj.r.squared,resultado_modelo2$adj.r.squared,resultado_modelo3$adj.r.squared,resultado_modelo4$adj.r.squared,resultado_modelo5$adj.r.squared,resultado_modelo6$adj.r.squared,resultado_modelo7$adj.r.squared,resultado_modelo8$adj.r.squared),
AIC    = c(AIC(modelo1), AIC(modelo2),AIC(modelo3), AIC(modelo4),AIC(modelo5), AIC(modelo6),AIC(modelo7), AIC(modelo8)),
BIC    = c(BIC(modelo1), BIC(modelo2),BIC(modelo3), BIC(modelo4),BIC(modelo5), BIC(modelo6),BIC(modelo7), BIC(modelo8)))
resultados
```
Nótese que los primeros cinco modelos tienen la misma variable dependiente, por lo que pueden ser comparados entre sí. Sin embargo, es importante señalar que el modelo 4 no incluye término independiente, por lo que el coeficiente de determinación no puede aplicarse de manera adecuada. Así, se concluye que, entre los cinco primeros modelos, el modelo 4 es el que presenta la mejor bondad de ajuste según los distintos criterios de información.
En cuanto a los modelos 6, 7 y 8, el modelo 8 nuevamente carece de término independiente, por lo que no es posible utilizar el coeficiente de determinación corregido como criterio de comparación. En este caso, la conclusión es que el modelo 7 presenta el menor valor en los criterios de información.
Cabe destacar que los criterios de información cuentan con una versión ajustada que permite comparar modelos con la misma variable endógena, pero con distinta forma funcional, como ocurre en este caso (véase @Uriel2019).
### Estimación y contraste de una función de producción Cobb-Douglas {.unnumbered}
Se dispone de información sobre la producción ($Y$), el factor trabajo ($L$) y el factor capital ($K$) de 15 empresas de un mismo sector:
| Empresa | $Y$ | $L$ | $K$ |
|:-------:|----:|----:|----:|
| 1 | 71 | 39 | 34 |
| 2 | 59 | 21 | 72 |
| 3 | 72 | 27 | 79 |
| 4 | 111 | 46 | 114 |
| 5 | 123 | 51 | 83 |
| 6 | 86 | 31 | 79 |
| 7 | 94 | 58 | 47 |
| 8 | 95 | 59 | 35 |
| 9 | 109 | 52 | 100 |
| 10 | 104 | 60 | 59 |
| 11 | 122 | 53 | 102 |
| 12 | 100 | 45 | 88 |
| 13 | 97 | 30 | 108 |
| 14 | 50 | 26 | 31 |
| 15 | 120 | 52 | 98 |
Se describe la siguiente función de producción Cobb-Douglas:
$$
Y_i = A\,L_i^{\beta_2}\,K_i^{\beta_3}\,e^{u_i}, \qquad i = 1,\dots,15,
$$
donde $u_i$ cumple las hipótesis clásicas del modelo lineal general, incluida la normalidad: $u_i \sim N(0,\sigma^2)$.
Se pide:
a) Linealizar el modelo y escribirlo en forma matricial.
b) Estimar los parámetros por Mínimos Cuadrados Ordinarios (MCO) e interpretar los coeficientes.
c) Calcular la suma de cuadrados de los residuos, la estimación de $\sigma^2$, el coeficiente de determinación $R^2$ y el $R^2$ corregido. Contrastar la significación global del modelo.
d) Obtener los intervalos de confianza al 95 % para $\beta_1$, $\beta_2$, $\beta_3$ y $\sigma^2$.
e) Contrastar, mediante el **test general de restricciones lineales** ($F$), la hipótesis de **rendimientos constantes a escala** ($\beta_2+\beta_3=1$), con $\alpha = 0{,}05$.
f) Estimar el modelo **restringido** imponiendo rendimientos constantes a escala (Mínimos Cuadrados Restringidos) y comprobar que el contraste $F$ basado en las sumas de cuadrados residuales coincide con el del apartado e).
g) Contrastar la restricción lineal $\beta_2 = \beta_3$ (igual elasticidad de la producción respecto al trabajo y al capital).
h) Resolver todos los apartados en **R**.
Valores críticos que pueden necesitarse: $t_{12;\,0{,}025} = 2{,}1788$; $F_{1,12;\,0{,}05} = 4{,}7472$; $F_{2,12;\,0{,}05} = 3{,}8853$; $\chi^2_{12;\,0{,}975} = 4{,}4038$ y $\chi^2_{12;\,0{,}025} = 23{,}3367$ (cola superior).
**a) Linealización y forma matricial**
Tomando logaritmos neperianos:
$$
\ln Y_i = \beta_1 + \beta_2 \ln L_i + \beta_3 \ln K_i + u_i, \qquad \beta_1 = \ln A .
$$
Llamando $y_i=\ln Y_i$, $l_i = \ln L_i$, $k_i=\ln K_i$, el modelo es lineal en los parámetros:
$$
\mathbf{y} = \mathbf{X}\boldsymbol{\beta} + \mathbf{u}, \qquad
\mathbf{y}=\begin{pmatrix} y_1\\ \vdots \\ y_{15}\end{pmatrix},\;
\mathbf{X}=\begin{pmatrix} 1 & l_1 & k_1\\ \vdots & \vdots & \vdots\\ 1 & l_{15} & k_{15}\end{pmatrix},\;
\boldsymbol{\beta}=\begin{pmatrix}\beta_1\\ \beta_2\\ \beta_3\end{pmatrix}.
$$
Datos transformados (4 decimales):
| Empresa | $y=\ln Y$ | $l=\ln L$ | $k=\ln K$ |
|:--:|--:|--:|--:|
| 1 | 4,2627 | 3,6636 | 3,5264 |
| 2 | 4,0775 | 3,0445 | 4,2767 |
| 3 | 4,2767 | 3,2958 | 4,3694 |
| 4 | 4,7095 | 3,8286 | 4,7362 |
| 5 | 4,8122 | 3,9318 | 4,4188 |
| 6 | 4,4543 | 3,4340 | 4,3694 |
| 7 | 4,5433 | 4,0604 | 3,8501 |
| 8 | 4,5539 | 4,0775 | 3,5553 |
| 9 | 4,6913 | 3,9512 | 4,6052 |
| 10 | 4,6444 | 4,0943 | 4,0775 |
| 11 | 4,8040 | 3,9703 | 4,6250 |
| 12 | 4,6052 | 3,8067 | 4,4773 |
| 13 | 4,5747 | 3,4012 | 4,6821 |
| 14 | 3,9120 | 3,2581 | 3,4340 |
| 15 | 4,7875 | 3,9512 | 4,5850 |
**b) Estimación MCO**
El estimador MCO es $\hat{\boldsymbol\beta} = (\mathbf{X}'\mathbf{X})^{-1}\mathbf{X}'\mathbf{y}$. Con los datos transformados:
$$
\mathbf{X}'\mathbf{X} =
\begin{pmatrix}
n & \sum l_i & \sum k_i\\
\sum l_i & \sum l_i^2 & \sum l_i k_i\\
\sum k_i & \sum l_i k_i & \sum k_i^2
\end{pmatrix}
=
\begin{pmatrix}
15 & 55{,}7694 & 63{,}5886\\
55{,}7694 & 209{,}0024 & 236{,}5094\\
63{,}5886 & 236{,}5094 & 272{,}3385
\end{pmatrix}
$$
$$
\mathbf{X}'\mathbf{y} =
\begin{pmatrix}
\sum y_i\\ \sum l_i y_i\\ \sum k_i y_i
\end{pmatrix}
=
\begin{pmatrix}
67{,}7093\\ 252{,}7682\\ 288{,}0555
\end{pmatrix}.
$$
Su inversa (obtenida por adjuntos o con calculadora matricial):
$$
(\mathbf{X}'\mathbf{X})^{-1} =
\begin{pmatrix}
14{,}319063 & -2{,}169214 & -1{,}459541\\
-2{,}169214 & 0{,}605747 & -0{,}019562\\
-1{,}459541 & -0{,}019562 & 0{,}361450
\end{pmatrix}.
$$
Por tanto:
$$
\hat{\boldsymbol\beta} = (\mathbf{X}'\mathbf{X})^{-1}\mathbf{X}'\mathbf{y} =
\begin{pmatrix}
0{,}7964\\ 0{,}6025\\ 0{,}3485
\end{pmatrix}
\quad\Longrightarrow\quad
\widehat{\ln Y_i} = 0{,}7964 + 0{,}6025\,\ln L_i + 0{,}3485\,\ln K_i .
$$
**Interpretación:**
* $\hat\beta_2 = 0{,}6025$ es la **elasticidad de la producción respecto al trabajo**: si $L$ aumenta un 1 % (con $K$ constante), la producción aumenta aproximadamente un 0,60 %, *ceteris paribus*.
* $\hat\beta_3 = 0{,}3485$ es la **elasticidad de la producción respecto al capital**: un aumento del 1 % en $K$ eleva la producción en un 0,35 %, *ceteris paribus*.
* $\hat\beta_2 + \hat\beta_3 = 0{,}9510$ mide los **rendimientos a escala**: si ambos factores aumentan un 1 %, la producción aumenta un 0,95 %. La estimación puntual sugiere rendimientos ligeramente decrecientes, pero habrá que contrastar si la diferencia respecto a 1 es significativa (apartado e).
* $\hat\beta_1 = 0{,}7964$ estima $\ln A$, de modo que $\hat A = e^{0{,}7964} \approx 2{,}22$ (parámetro de eficiencia o productividad total de los factores).
**c) SCR, $\hat\sigma^2$, $R^2$, $\bar R^2$ y significación global**
**Suma de cuadrados de los residuos:**
$$
SCR = \mathbf{e}'\mathbf{e} = \mathbf{y}'\mathbf{y} - \hat{\boldsymbol\beta}'\mathbf{X}'\mathbf{y}
= 306{,}661254 - 306{,}610946 = 0{,}050308 .
$$
> **Nota:** esta resta es muy sensible al redondeo; conviene trabajar con al menos 6 decimales.
**Estimación insesgada de la varianza de la perturbación** ($n-k = 15-3 = 12$ g.l.):
$$
\hat\sigma^2 = \frac{SCR}{n-k} = \frac{0{,}050308}{12} = 0{,}004192, \qquad \hat\sigma = 0{,}0647 .
$$
**Suma de cuadrados total:**
$$
SCT = \mathbf{y}'\mathbf{y} - n\bar y^2 = 306{,}661254 - 15\cdot(4{,}513952)^2 = 306{,}661254 - 305{,}636374 = 1{,}024880 .
$$
**Coeficiente de determinación y coeficiente corregido:**
$$
R^2 = 1 - \frac{SCR}{SCT} = 1 - \frac{0{,}050308}{1{,}024880} = 0{,}9509,
$$
$$
\bar R^2 = 1 - \frac{SCR/(n-k)}{SCT/(n-1)} = 1 - \frac{0{,}050308/12}{1{,}024880/14} = 0{,}9427 .
$$
El 95,1 % de la variabilidad del logaritmo de la producción queda explicada por los logaritmos de trabajo y capital.
**Contraste de significación global** ($H_0:\beta_2=\beta_3=0$):
$$
F = \frac{R^2/(k-1)}{(1-R^2)/(n-k)} = \frac{(STC-SCR)/2}{SCR/12} = \frac{0{,}974572/2}{0{,}004192} = 116{,}23 \;>\; F_{2,12;\,0{,}05}=3{,}8853 .
$$
Se rechaza $H_0$: el modelo es globalmente significativo.
**d) Intervalos de confianza al 95 %**
La matriz de varianzas-covarianzas estimada es $\widehat{\mathrm{Var}}(\hat{\boldsymbol\beta}) = \hat\sigma^2(\mathbf{X}'\mathbf{X})^{-1}$:
$$
\widehat{\mathrm{Var}}(\hat{\boldsymbol\beta}) = 0{,}004192 \cdot (\mathbf{X}'\mathbf{X})^{-1} =
\begin{pmatrix}
0{,}060030 & -0{,}009094 & -0{,}006119\\
-0{,}009094 & 0{,}002539 & -0{,}000082\\
-0{,}006119 & -0{,}000082 & 0{,}001515
\end{pmatrix}.
$$
Errores estándar: $\;s_{\hat\beta_1} = 0{,}2450,\quad s_{\hat\beta_2}=0{,}0504,\quad s_{\hat\beta_3}=0{,}0389$.
Los intervalos son $\hat\beta_j \pm t_{12;\,0{,}025}\, s_{\hat\beta_j}$, con $t_{12;\,0{,}025}=2{,}1788$:
| Parámetro | Estimación | Error estándar | IC 95 % |
|:--|--:|--:|:--:|
| $\beta_1$ | 0,7964 | 0,2450 | $[\,0{,}2626;\; 1{,}3302\,]$ |
| $\beta_2$ | 0,6025 | 0,0504 | $[\,0{,}4927;\; 0{,}7123\,]$ |
| $\beta_3$ | 0,3485 | 0,0389 | $[\,0{,}2637;\; 0{,}4333\,]$ |
Ninguno de los intervalos contiene el cero, por lo que las tres estimaciones son individualmente significativas al 5 %.
**Intervalo para $\sigma^2$**, basado en $(n-k)\hat\sigma^2/\sigma^2 \sim \chi^2_{n-k}$:
$$
\left[\frac{(n-k)\hat\sigma^2}{\chi^2_{12;\,0{,}025}},\; \frac{(n-k)\hat\sigma^2}{\chi^2_{12;\,0{,}975}}\right]
= \left[\frac{0{,}050308}{23{,}3367},\; \frac{0{,}050308}{4{,}4038}\right]
= [\,0{,}002156;\; 0{,}011424\,].
$$
**e) Rendimientos constantes a escala: test general $F$**
La hipótesis típica en una Cobb-Douglas es la de **rendimientos constantes a escala**:
$$
H_0: \beta_2 + \beta_3 = 1 \qquad \text{frente a} \qquad H_1: \beta_2 + \beta_3 \neq 1 .
$$
Se escribe en la forma general $H_0: \mathbf{R}\boldsymbol\beta = \mathbf{r}$, con $q=1$ restricción:
$$
\mathbf{R} = (0 \;\; 1 \;\; 1), \qquad \mathbf{r} = 1 .
$$
El estadístico general es
$$
F = \frac{(\mathbf{R}\hat{\boldsymbol\beta}-\mathbf{r})'\left[\mathbf{R}(\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}'\right]^{-1}(\mathbf{R}\hat{\boldsymbol\beta}-\mathbf{r})/q}{\hat\sigma^2} \;\sim\; F_{q,\,n-k} \quad \text{bajo } H_0 .
$$
Cálculos:
* $\mathbf{R}\hat{\boldsymbol\beta} - \mathbf{r} = 0{,}602531 + 0{,}348499 - 1 = -0{,}048969$.
* $\mathbf{R}(\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}' = a_{22} + a_{33} + 2a_{23} = 0{,}605747 + 0{,}361450 + 2(-0{,}019562) = 0{,}928072$.
$$
F = \frac{(-0{,}048969)^2 / 1}{0{,}928072 \cdot 0{,}004192} = \frac{0{,}002398}{0{,}003891} = 0{,}6163 .
$$
Como $F = 0{,}6163 < F_{1,12;\,0{,}05} = 4{,}7472$ (p-valor $= 0{,}448$), **no se rechaza** la hipótesis de rendimientos constantes a escala.
**f) Estimación restringida (MCR) y contraste vía SCR**
$$
\tilde{\boldsymbol\beta} = \hat{\boldsymbol\beta} - (\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}'\left[\mathbf{R}(\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}'\right]^{-1}(\mathbf{R}\hat{\boldsymbol\beta}-\mathbf{r}).
$$
Con $(\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}' = (-3{,}628755;\; 0{,}586184;\; 0{,}341888)'$:
$$
\tilde{\boldsymbol\beta} =
\begin{pmatrix} 0{,}7964\\ 0{,}6025\\ 0{,}3485\end{pmatrix}
- \begin{pmatrix} -3{,}628755\\ 0{,}586184\\ 0{,}341888\end{pmatrix}\frac{-0{,}048969}{0{,}928072}
= \begin{pmatrix} 0{,}6049\\ 0{,}6335\\ 0{,}3665\end{pmatrix},
$$
que coincide con el método 1 y verifica $\tilde\beta_2+\tilde\beta_3 = 1$.
**Contraste $F$ a partir de las sumas de cuadrados residuales.** La SCR del modelo restringido es $SCR_R = 0{,}052892$:
$$
F = \frac{(SCR_R - SCR)/q}{SCR/(n-k)} = \frac{(0{,}052892 - 0{,}050308)/1}{0{,}050308/12} = 0{,}6163 ,
$$
idéntico al obtenido en el apartado e). La conclusión es la misma: los datos son compatibles con rendimientos constantes a escala.
**g) Contraste de la restricción $\beta_2 = \beta_3$**
$$
H_0: \beta_2 - \beta_3 = 0, \qquad \mathbf{R} = (0\;\; 1\;\; -1),\quad r = 0 .
$$
* $\mathbf{R}\hat{\boldsymbol\beta} - r = 0{,}602531 - 0{,}348499 = 0{,}254032$.
* $\mathbf{R}(\mathbf{X}'\mathbf{X})^{-1}\mathbf{R}' = a_{22} + a_{33} - 2a_{23} = 0{,}605747 + 0{,}361450 + 0{,}039125 = 1{,}006322$.
$$
F = \frac{(0{,}254032)^2}{1{,}006322 \cdot 0{,}004192} = \frac{0{,}064532}{0{,}004219} = 15{,}30 \;>\; F_{1,12;\,0{,}05} = 4{,}7472 .
$$
Se **rechaza** $H_0$ (p-valor $\approx 0{,}002$): las elasticidades de trabajo y capital son significativamente distintas; la producción es más sensible al factor trabajo.
Comprobación con el modelo restringido: imponiendo $\beta_2=\beta_3=\beta$ se estima $\ln Y_i = \beta_1 + \beta\,(\ln L_i + \ln K_i) + u_i$, que da $\tilde\beta_1 = 0{,}9755$, $\tilde\beta = 0{,}4447$ y $SCR_R = 0{,}114435$, de modo que
$$
F = \frac{0{,}114435 - 0{,}050308}{0{,}004192} = 15{,}30 .
$$
**h) Resolución en R**
Partimos de los datos originales a partir de los que calculamos su logarítmo:
```{r datos}
datos <- data.frame(
  Y = c(71, 59, 72, 111, 123, 86, 94, 95, 109, 104, 122, 100, 97, 50, 120),
  L = c(39, 21, 27,  46,  51, 31, 58, 59,  52,  60,  53,  45, 30, 26,  52),
  K = c(34, 72, 79, 114,  83, 79, 47, 35, 100,  59, 102,  88, 108, 31, 98)
)

datos$y <- log(datos$Y)
datos$l <- log(datos$L)
datos$k <- log(datos$K)

round(datos, 4)
```
En primer lugar procedemos a la estimación con `lm()`:
```{r lm}
modelo <- lm(log(Y) ~ log(L) + log(K), data = datos)
summary(modelo)
```
Se obtienen los intervalos de confianza (se puede cambiar el nivel de confianza modificando `level`) y la matriz de varianzas-covarianzas de los estimadores. También, se calcula la suma de los estimadores para ver si suman 1 y se obtiene la estimación de la variable $A$:
```{r lm-extra}
confint(modelo, level = 0.95) # IC de los coeficientes
vcov(modelo) # matriz de var-cov
sum(coef(modelo)[2:3]) # rendimientos a escala estimados
exp(coef(modelo)[1]) # estimación de A
```
Para realizar el contraste general de rendimientos constantes a escala, se puede hacer con una función genérica para el test $F$ de $H_0:\mathbf{R}\boldsymbol\beta=\mathbf{r}$:
```{r test-general}
test_F <- function(modelo, R, r) {
  R <- matrix(R, ncol = length(coef(modelo)))
  b <- coef(modelo)
  q <- nrow(R)
  d <- R %*% b - r
  Fc <- as.numeric(t(d) %*% solve(R %*% vcov(modelo) %*% t(R)) %*% d / q)
  gl2 <- df.residual(modelo)
  c(F = Fc, gl1 = q, gl2 = gl2,
    F_critico = qf(0.95, q, gl2),
    p_valor = pf(Fc, q, gl2, lower.tail = FALSE))
}

# H0: beta2 + beta3 = 1
test_F(modelo, R = c(0, 1, 1), r = 1)
```
Se concluye que no se puede rechazar la hipótesis nula con los niveles de confianza habituales.
Si está instalado el paquete **car**, el mismo contraste se obtiene directamente:
```{r car, eval = requireNamespace("car", quietly = TRUE)}
car::linearHypothesis(modelo, "log(L) + log(K) = 1")
```
Se observa que se obtiene exactamente el mismo resultado.
Por otro lado, para realizar el contraste de $\beta_2 = \beta_3$, volvemos a usar la misma función:
```{r b2-igual-b3}
test_F(modelo, R = c(0, 1, -1), r = 0)
```
A continuación, se obtiene el gráfico de los valores observados frente a ajustados:
```{r grafico, fig.width = 6, fig.height = 4.5}
plot(fitted(modelo), log(datos$Y), pch = 19, col = "steelblue",
     xlab = "ln Y ajustado", ylab = "ln Y observado",
     main = "Cobb-Douglas: observados vs. ajustados")
abline(0, 1, lty = 2, col = "grey40")
text(fitted(modelo), log(datos$Y), labels = 1:n, pos = 4, cex = 0.7)
```
## Prácticas propuestas
1. Se plantea un modelo para explicar la inflación en España para los años 2006-2024, en función de la tasa de desempleo y el precio de la energia (en euros por megavatio-hora), a partir de los siguientes datos obtenidos del Instituto Nacional de Estadística (INE) y de statista.com:
```{r}
philips= read_excel('data/BD_PHILIPS.xlsx')
philips=as.data.frame(philips)
```
Se pide:
a. Representar la serie temporal de la inflación en función de la tasa de desempleo.
b. Estimación del modelo que explique la inflación en función de la tasa de desempleo.
c. Interprete los coeficientes estimados.
d. Estimación del modelo que explique la inflación en función de la tasa de desempleo y el precio de la energia. Compare ambos modelos en términos de bondad de ajuste.
e. Analice la significatividad individual y global del último modelo estimado.
f. Contraste al 95% si por cada unidad porcentual que aumente la el desempleo la inflación podría llegar a disminuir un 1%, ceteris paribus.
g. Contraste si el efecto de la variable tasa de desempleo puede ser el mismo que el de la variable precio de la energia pero con signo contrario.
h. Obtenga una previsión de la inflación para el año 2025, suponiendo que la tasa de paro ha sido de 10.8% y el precio medio de la energia de 85 euros.
i. Analizar la permanencia estructural del modelo sabiendo que finalmente la inflación en el año 2025 fue de 2.5%.
2. El departamento de Sanidad de E.E.U.U. quiere estudiar la relación entre el gasto sanitario agregado en billones de dólares (exphlth), la renta personal disponible agregada también en billones de dólares (income), el porcentaje de población que supera los 65 años en el año 2005 (seniors) y la población en millones (pop). Para ello encarga un estudio a dos becarios de la facultad de Económicas de Harvard poniendo a su disposición datos de 2005 para dichas variables sobre 51 estados americanos. (Fichero data8-3.gdt Ramanathan).
a. Escribe la ecuación del modelo que te permita analizar la influencia de las variables explicativas income, seniors y pop sobre la variable exphlth.
b. Interpreta los coeficientes del modelo anterior
c. Estima la ecuación propuesta por MCO. Interpreta los coeficientes estimados del modelo. ¿Son sus signos coherentes con la teoría económica?
d. ¿Cuál es la varianza de cada uno de los estimadores de los parámetros?
e. Interpreta el coeficiente de determinación del modelo
f. Obtener el valor del coeficiente de determinación corregido
g. Estimar ahora el modelo eliminando la variable seniors, interpretar el modelo y comparar su bondad.
3. Se tiene una base de datos para el periodo 1990-2024 de la esperanza de vida al nacer y el gasto sanitario público (en millones de euros), asi como el porcentaje del gasto en función del PIB y la renta per capita (medida en euros). `
```{r}
knitr::opts_chunk$set(echo = TRUE)
library(readxl)
datos <- read_excel("data/bd6_esperanza.xlsx")
```
Se proponen distintas especificaciones del modelo incluyendo la variable Gasto Sanitario (en millones de euros) y renta per capita (en euros)
```{r}
m_linlin <- lm(Esperanza ~ Gasto + Renta, data = datos)
m_loglin <- lm(log(Esperanza)~ Gasto + Renta, data = datos)
m_linlog <- lm(Esperanza ~ log(Gasto) + Renta, data = datos)
m_loglog <- lm(log(Esperanza) ~ log(Gasto) + log(Renta), data = datos)
summary(m_linlin)
summary(m_loglin)
summary(m_linlog)
summary(m_loglog)
```
Comparar en terminos de bondad de ajuste, pero con otra especificación que use en porcentaje de gasto Sanitario en función del PIB en lugar del gasto sanitario:
```{r}
m_linlin_ratio <- lm(Esperanza ~ GastoPIB + Renta, data = datos)
m_loglin_ratio <- lm(log(Esperanza)~ GastoPIB + Renta, data = datos)
m_linlog_ratio <- lm(Esperanza ~ log(GastoPIB) + Renta, data = datos)
m_loglog_ratio <- lm(log(Esperanza) ~ log(GastoPIB)+Renta, data = datos)
summary(m_linlin_ratio)
summary(m_loglin_ratio)
summary(m_linlog_ratio)
summary(m_loglog_ratio)
```
```{r}
m_linlin_sinrenta <- lm(Esperanza ~ GastoPIB, data = datos)
m_loglin_sinrenta <- lm(log(Esperanza)~ GastoPIB, data = datos)
m_linlog_sinrenta <- lm(Esperanza ~ log(GastoPIB), data = datos)
m_loglog_sinrenta <- lm(log(Esperanza) ~ log(GastoPIB), data = datos)
summary(m_linlin_sinrenta)
summary(m_loglin_sinrenta)
summary(m_linlog_sinrenta)
summary(m_loglog_sinrenta)
```
Se pide:\\
a. Comparar en terminos de bondad de ajuste, pero con otra especificación que elimine la variable renta:
```{r}
resultados <- data.frame(
  modelo = c("lin-lin", "log-lin", "lin-log", "log-log",
             "lin-lin ratio", "log-lin ratio", "lin-log ratio", "log-log ratio",
             "lin-lin sin renta", "log-lin sin renta", "lin-log sin renta", "log-log sin renta"),
  R2 = c(summary(m_linlin)$r.squared,
         summary(m_loglin)$r.squared,
         summary(m_linlog)$r.squared,
         summary(m_loglog)$r.squared,
         summary(m_linlin_ratio)$r.squared,
         summary(m_loglin_ratio)$r.squared,
         summary(m_linlog_ratio)$r.squared,
         summary(m_loglog_ratio)$r.squared,
         summary(m_linlin_sinrenta)$r.squared,
         summary(m_loglin_sinrenta)$r.squared,
         summary(m_linlog_sinrenta)$r.squared,
         summary(m_loglog_sinrenta)$r.squared),
  R2_ajustado = c(summary(m_linlin)$adj.r.squared,
                  summary(m_loglin)$adj.r.squared,
                  summary(m_linlog)$adj.r.squared,
                  summary(m_loglog)$adj.r.squared,
                  summary(m_linlin_ratio)$adj.r.squared,
                  summary(m_loglin_ratio)$adj.r.squared,
                  summary(m_linlog_ratio)$adj.r.squared,
                  summary(m_loglog_ratio)$adj.r.squared,
                  summary(m_linlin_sinrenta)$adj.r.squared,
                  summary(m_loglin_sinrenta)$adj.r.squared,
                  summary(m_linlog_sinrenta)$adj.r.squared,
                  summary(m_loglog_sinrenta)$adj.r.squared)
)
resultados
```
b. A partir de la siguiente información, realice una selección de modelos:
```{r}
AIC(m_linlin,m_loglin,m_linlog,m_loglog,m_linlin_ratio,m_loglin_ratio,m_linlog_ratio,m_loglog_ratio,m_linlin_sinrenta,m_loglin_sinrenta,m_linlog_sinrenta,m_loglog_sinrenta)
BIC(m_linlin,m_loglin,m_linlog,m_loglog,m_linlin_ratio,m_loglin_ratio,m_linlog_ratio,m_loglog_ratio,m_linlin_sinrenta,m_loglin_sinrenta,m_linlog_sinrenta,m_loglog_sinrenta)
```
c. Selecciona un modelo para el caso de trabajar con la variable dependiente y otro para trabajar el modelo con la variable dependiente en su unidad original, y realiza predicciones de la esperanza de vida al nacer en el año 2025, suponiendo que el gasto sanitario es de 99.500 millones de euros, que supone un 8% del PIB y que la renta per capita es de 36.000 euros.
d. Construye el intervalo de predicción del valor individual de la variable dependiente y concluye en relación a la permanencia estructural del modelo sabiendo que la esperanza de vida al nacer en el año 2025 es de 84 años.
4. Tenemos un modelo que explica el precio de la vivienda (en miles de euros) en función de los metros cuadrados, el número de habitaciones y el número de baños. Tenemos diez viviendas con los siguientes datos:
| Vivienda | Metros cuadrados | Habitaciones | Baños | Precio (miles de €) |
|:--------:|-----------------:|-------------:|------:|---------------------:|
| 1 | 65 | 2 | 1 | 145 |
| 2 | 80 | 3 | 2 | 180 |
| 3 | 95 | 3 | 2 | 210 |
| 4 | 110 | 4 | 3 | 250 |
| 5 | 125 | 4 | 3 | 285 |
| 6 | 140 | 5 | 4 | 320 |
| 7 | 75 | 2 | 1 | 165 |
| 8 | 100 | 3 | 2 | 225 |
| 9 | 130 | 4 | 3 | 300 |
| 10 | 150 | 5 | 4 | 350 |
a. Construye la matriz de diseño $X$ del modelo, incluyendo una columna de unos para el término independiente. Indica el número de filas y columnas de la matriz.
b. Calcula el rango de la matriz $X$. Compara el rango obtenido con el número de columnas de $X$. ¿Qué conclusión puedes extraer sobre la independencia lineal de las variables explicativas?
c. A partir de los resultados anteriores, determina si es posible estimar de forma única los coeficientes del modelo de regresión mediante Mínimos Cuadrados Ordinarios. Justifica tu respuesta.
d. Estima un modelo usando solo la variable metros cuadrados y otro modelo alternativo, usando la variable metros cuadrados y el número de habitaciones. Compara ambos modelos en términos de bondad de ajuste.
5. Dado el modelo de regresión lineal simple $\mathbf{S} = \beta_{1} + \beta_{2} \cdot \mathbf{E} + \mathbf{u}$, donde $\mathbf{S}$ es el salario medio por hora (medido en euros) y $\mathbf{E}$ son los años de escolarización, obtenga (usando, al menos, cuatro decimales) la estimación de las cantidades constantes del modelo (interpretando las estimaciones obtenidas) y el coeficiente de determinación corregido, a partir de la siguiente información:
```{r}
Salario = c(4.45, 5.77, 7.31, 7.81, 10.67, 13.61)
Escolaridad = c(6, 7, 10, 12, 15, 17)

datos = data.frame(Salario, Escolaridad)
names(datos) = c("Salario medio (euros/hora)", "Escolarización (años)")

kable(datos, align="c")
```
```{r}
y = Salario
cte = rep(1, length(y))
X = cbind(cte, Escolaridad)
#
n = nrow(X)
k = ncol(X)
XX = crossprod(X)
XXinv = solve(XX)
Xy = crossprod(X, y)
colnames(Xy) = c("Salario")
#
beta = as.matrix(XXinv%*%Xy)
e = y - X%*%beta
sigma = crossprod(e)/(n-k)
SCT = crossprod(y) - n*mean(y)*mean(y)
SCE = crossprod(beta, Xy) - n*mean(y)*mean(y)
SCR = crossprod(y) - crossprod(beta, Xy)
R2_1 = SCE/SCT
R2_2 = 1 - SCR/SCT
R2 = R2_1
R2c = 1 - (1-R2)*((n-1)/(n-k))
solucion = list(XX, XXinv, Xy, beta, e, as.double(sigma), as.double(SCT), as.double(SCE), as.double(SCR), as.double(R2_1), as.double(R2_2), as.double(R2c))
names(solucion) = c("XtX", "inversa XtX", "Xty", "beta", "e", "sigma", "SCT", "SCE", "SCR", "R2 = SCE/SCT", "R2 = 1 - SCR/SCT", "R2 corregido")
solucion0 = solucion
```
¿Qué interpretación tiene un residuo positivo/negativo?
6. Dado el modelo de regresión lineal múltiple $\mathbf{y} = \beta_{1} + \beta_{2} \cdot \mathbf{V} + \beta_{3} \cdot \mathbf{Z} + \mathbf{u}$ con $n=15$ observaciones y $k=3$ variables independientes, en los siguientes casos, calcule:
a. La estimación de los coeficientes de las variables independientes: $\widehat{\boldsymbol{\beta}} = \left( \mathbf{X}^{t} \mathbf{X} \right)^{-1} \mathbf{X}^{t} \mathbf{y}$. Interpretación.
b. Los errores de la estimación realizada: $\mathbf{e} = \mathbf{y} - \widehat{\mathbf{y}} = \mathbf{y} - \mathbf{X} \widehat{\boldsymbol{\beta}}$.
c. La estimación de la varianza de la perturbación aleatoria: $\widehat{\sigma} = \frac{\mathbf{e}^{t} \mathbf{e}}{n-k}$.
d. La suma de cuadrados totales: $SCT = \mathbf{y}^{t}\mathbf{y} - n \cdot \overline{\mathbf{y}}^{2}$.
e. La suma de cuadrados explicada: $SCE = \widehat{\boldsymbol{\beta}}^{t} \mathbf{X}^{t} \mathbf{y} - n \cdot \overline{\mathbf{y}}^{2}$.
f. La suma de cuadrados de los residuos: $SCR = \mathbf{y}^{t}\mathbf{y} - \widehat{\boldsymbol{\beta}}^{t} \mathbf{X}^{t} \mathbf{y}$.
g. El coeficiente de determinación: $R^{2} = \frac{SCE}{SCT} = 1 - \frac{SCR}{SCT}$. ¿Se verifica la igualdad? ¿Por qué? Interpretación.
h. El coeficiente de determinación corregido: $\overline{R}^{2} = 1 - (1-R^{2}) \cdot \frac{n-1}{n-k}$.
Responda de forma razonada todas las cuestiones planteadas usando, al menos, cuatro decimales.
**([Caso A]{.underline})**
$\left( \mathbf{y}, \mathbf{X} \right) =$
```{r}
X = read.table("data/ortogonal1.txt", header=TRUE, sep=";", dec = ".")  # muy importante indicar el delimitador decimal (si no se dice nada, es el punto)
X = as.matrix(X)
y = 3*X[,1] + 2*X[,2] - 3*X[,3] + round(rnorm(nrow(X), 0, 2), 0)

data.frame(y, X)
```
$\left( \mathbf{X}^{t} \mathbf{X} \right)^{-1} =$
```{r}
XX = crossprod(X)
XXinv = solve(XX)
XXinv
```
$\mathbf{X}^{t} \mathbf{y} =$
```{r}
Xy = crossprod(X, y)
colnames(Xy) = c("y")
Xy
```
```{r}
# soluciones
n = nrow(X)
k = ncol(X)
beta = as.matrix(XXinv%*%Xy)
e = y - X%*%beta
sigma = crossprod(e)/(n-k)
SCT = crossprod(y) - n*mean(y)*mean(y)
SCE = crossprod(beta, Xy) - n*mean(y)*mean(y)
SCR = crossprod(y) - crossprod(beta, Xy)
R2_1 = SCE/SCT
R2_2 = 1 - SCR/SCT
R2 = R2_1
R2c = 1 - (1-R2)*((n-1)/(n-k))
solucion = list(beta, e, as.double(sigma), as.double(SCT), as.double(SCE), as.double(SCR), as.double(R2_1), as.double(R2_2), as.double(R2c))
names(solucion) = c("beta", "e", "sigma", "SCT", "SCE", "SCR", "R2 = SCE/SCT", "R2 = 1 - SCR/SCT", "R2 corregido")
solucionA = solucion
```
**([Caso B]{.underline})**
$\left( \mathbf{y}, \mathbf{X} \right) =$
```{r}
X = read.table("data/ortogonal2.txt", header=TRUE, sep=";", dec = ".")  # muy importante indicar el delimitador decimal (si no se dice nada, es el punto)
X = as.matrix(X)
y = 3*X[,1] + 2*X[,2] - 3*X[,3] + round(rnorm(nrow(X), 0, 2), 0)

data.frame(y, X)
```
$\left( \mathbf{X}^{t} \mathbf{X} \right)^{-1} =$
```{r}
XX = crossprod(X)
XXinv = solve(XX)
XXinv
```
$\mathbf{X}^{t} \mathbf{y} =$
```{r}
Xy = crossprod(X, y)
colnames(Xy) = c("y")
Xy
```
```{r}
# soluciones
n = nrow(X)
k = ncol(X)
beta = as.matrix(XXinv%*%Xy)
e = y - X%*%beta
sigma = crossprod(e)/(n-k)
SCT = crossprod(y) - n*mean(y)*mean(y)
SCE = crossprod(beta, Xy) - n*mean(y)*mean(y)
SCR = crossprod(y) - crossprod(beta, Xy)
R2_1 = SCE/SCT
R2_2 = 1 - SCR/SCT
R2 = R2_1
R2c = 1 - (1-R2)*((n-1)/(n-k))
solucion = list(beta, e, as.double(sigma), as.double(SCT), as.double(SCE), as.double(SCR), as.double(R2_1), as.double(R2_2), as.double(R2c))
names(solucion) = c("beta", "e", "sigma", "SCT", "SCE", "SCR", "R2 = SCE/SCT", "R2 = 1 - SCR/SCT", "R2 corregido")
solucionB = solucion
```
**([Caso C]{.underline})**
$\left( \mathbf{y}, \mathbf{X} \right) =$
```{r}
X = read.table("data/ortogonal3.txt", header=TRUE, sep=";", dec = ".")  # muy importante indicar el delimitador decimal (si no se dice nada, es el punto)
X = as.matrix(X)
y = 3*X[,1] + 2*X[,2] - 3*X[,3] + round(rnorm(nrow(X), 0, 2), 0)

data.frame(y, X)
```
$\left( \mathbf{X}^{t} \mathbf{X} \right)^{-1} =$
```{r}
XX = crossprod(X)
XXinv = solve(XX)
XXinv
```
$\mathbf{X}^{t} \mathbf{y} =$
```{r}
Xy = crossprod(X, y)
colnames(Xy) = c("y")
Xy
```
```{r}
# soluciones
n = nrow(X)
k = ncol(X)
beta = as.matrix(XXinv%*%Xy)
e = y - X%*%beta
sigma = crossprod(e)/(n-k)
SCT = crossprod(y) - n*mean(y)*mean(y)
SCE = crossprod(beta, Xy) - n*mean(y)*mean(y)
SCR = crossprod(y) - crossprod(beta, Xy)
R2_1 = SCE/SCT
R2_2 = 1 - SCR/SCT
R2 = R2_1
R2c = 1 - (1-R2)*((n-1)/(n-k))
solucion = list(beta, e, as.double(sigma), as.double(SCT), as.double(SCE), as.double(SCR), as.double(R2_1), as.double(R2_2), as.double(R2c))
names(solucion) = c("beta", "e", "sigma", "SCT", "SCE", "SCR", "R2 = SCE/SCT", "R2 = 1 - SCR/SCT", "R2 corregido")
solucionC = solucion
```
7. Dado el modelo de regresión lineal multiple $\mathbf{PA} = \beta_{1} + \beta_{2} \cdot \mathbf{P} + \beta_{3} \cdot \mathbf{A} + \mathbf{u}$ donde $\mathbf{PA}$ es la presión arterial (medida en milímetros de mercurio), $\mathbf{P}$ el peso (medido en kilogramos) y $\mathbf{A}$ la altura (medida en metros). Interprete los coeficientes de las variables independientes. ¿Es intuitivo que la altura cambie y el peso no varie?
8. Dado el modelo de regresión lineal multiple $\mathbf{S} = \beta_{1} + \beta_{2} \cdot \mathbf{E} + \beta_{3} \cdot \mathbf{G} + \mathbf{u}$ donde $\mathbf{S}$ es el salario medio por hora (medido en euros), $\mathbf{E}$ son los años de escolarización y $\mathbf{E}$ es el género (donde masculino se codifica como 1 y en cualquier otro caso se usa el 0), interprete $\beta_{1}$, $\beta_{2}$, $\beta_{3}$ y $\beta_{1}+\beta_{3}$
9. Dado el modelo de regresión lineal multiple: $$\mathbf{S} = \beta_{1} + \beta_{2} \cdot \mathbf{E} + \beta_{3} \cdot \mathbf{G} + \beta_{4} \cdot \mathbf{G} \times \mathbf{E} + \mathbf{u},$$ donde $\mathbf{S}$ es el salario medio por hora (medido en euros), $\mathbf{E}$ son los años de escolarización y $\mathbf{E}$ es el género (donde masculino se codifica como 1 y en cualquier otro caso se usa el 0). Se pide contestar de forma razonada las siguientes cuestiones:
a. Obtenga el efecto de la escolarización sobre el salario medio si $(\widehat{\beta}_{2}, \widehat{\beta}_{4}) = (4, 2)$ ó $(\widehat{\beta}_{2}, \widehat{\beta}_{4}) = (4, -3)$.
b. ¿Cuál sería la interpretación de $\beta_{1}$? ¿Esta interpretación cambia si se centra la variable referente a los años de escolarización?
c. ¿Cómo se obtendría el efecto del género sobre el salario medio?