flowchart TD
    1[Pregunta económica] --> 2[Especificación del modelo]
    2 --> 3[Obtención de datos]
    3 --> 4[Estimación]
    4 --> 5{Validación}
    5 -->|Sí| 6[Interpretación y predicción]
    5 -->|No| 2
1 Introducción a la Econometría
ImportanteObjetivos de aprendizaje
Al finalizar este capítulo el estudiante será capaz de:
- Comprender qué es la Econometría y cuál es su papel dentro de las Finanzas y la Contabilidad.
- Diferenciar entre un modelo económico y un modelo econométrico.
- Identificar las principales fases del método econométrico.
- Reconocer los distintos tipos de datos utilizados en Econometría.
- Comprender por qué los modelos econométricos constituyen una herramienta esencial para la toma de decisiones empresariales y financieras.
- Familiarizarse con el caso de estudio que se utilizará a lo largo del libro.
1.1 Econometría y modelos econométricos
¿Qué es la Econometría?
El concepto moderno de ``Econometría’’ se le atribuye a (Frisch 1926), aunque fue en el primer volumen de la revista Econometrica, de la que era editor (Frisch 1936), donde asentó el concepto de econometría:
[…] su definición queda implícita en los objetivos que impulsaron la Sociedad Econométrica y que están recogidos en la sección I de la constitución de la misma. La Sociedad Econométrica es una sociedad internacional dedicada al avance de la Teoría Económica en su relación con la Estadística y las Matemáticas… Su principal objetivo es promover estudios que conduzcan a la unificación de los enfoques teórico-cuantitativos y empírico-cuantitativos en el estudio de los problemas económicos.
Esta descripción de los objetivos de la Sociedad no constituye propiamente una definición, ``pero indica el objeto de la Econometría: el estudio cuantitativo de los problemas económicos’’. De entre la multitud de definiciones existentes en la literatura, se podría destacar la aportada por (Judge et al. 1985):
La Econometría, usando la Teoría Económica, las Matemáticas y la Inferencia Estadística como fundamentos analíticos, y los datos económicos como la base informativa, proporciona una base para: 1. Modificar, refinar o posiblemente refutar las conclusiones en el cuerpo de conocimientos conocido como Teoría Económica. 2. Conseguir signos, magnitudes y afirmaciones de calidad para los coeficientes de las variables en las relaciones económicas, de modo que esta información puede usarse como base para la elección y toma de decisiones.
Así, se puede decir que la Econometría es la disciplina que combina la Teoría Económica, la Estadística, las Matemáticas y la Informática con el objetivo de analizar relaciones económicas utilizando datos observados. Su finalidad no es únicamente describir los datos, sino explicar el comportamiento de las variables económicas, contrastar hipótesis formuladas por la teoría y proporcionar información útil para la toma de decisiones.
En términos sencillos, la Econometría intenta responder preguntas del tipo:
- ¿Cómo cambia la rentabilidad de una empresa cuando aumenta su endeudamiento?
- ¿Cómo afecta una subida de los tipos de interés al precio de los bonos?
- ¿Qué efecto tiene la liquidez sobre la capacidad de una empresa para generar beneficios?
- ¿Qué efecto tiene el mercado financiero europeo sobre el español?
Responder a estas preguntas requiere construir modelos capaces de cuantificar estas relaciones. La Econometría constituye, por tanto, el puente entre la teoría y la evidencia empírica. Mientras que la teoría económica propone relaciones entre variables, la Econometría utiliza datos para comprobar si dichas relaciones realmente se observan en la práctica.
Modelo económico frente a modelo econométrico
En términos generales, un modelo es una representación simplificada de la realidad que permite estudiar el comportamiento de un fenómeno de interés. En Economía y Finanzas, los modelos constituyen una herramienta esencial para comprender cómo se relacionan distintas variables y para predecir el efecto que un cambio en una de ellas puede producir sobre las demás.
Sin embargo, es importante distinguir entre un modelo económico y un modelo econométrico, ya que ambos persiguen objetivos diferentes.
- El modelo económico expresa, de forma simplificada, las relaciones que la teoría espera encontrar entre distintas variables en forma matemática, es decir, \(y=f(x)\). Sin embargo, no todas las relaciones se pueden expresar matemáticamente ya que hay cuestiones no observables que no se pueden incluir en la expresión matemática.
- El modelo econométrico reconoce que la realidad está influida por numerosos factores no observados y, por tanto, incorpora una componente aleatoria. Ese término recibe el nombre de perturbación aleatoria y suele representarse mediante la letra (\(u\)). En los modelos econométricos básicos, además, se suele asumir que las relaciones entre las variables son lineales. Tras aplicar un procedimiento de estimación obtendremos una estimación para los parámetros. Más adelante aprenderemos cómo estimar correctamente estos coeficientes y cómo evaluar si estas relaciones son estadísticamente significativas.
PrecauciónError habitual confundir correlación con causalidad
Una de las ideas más importantes de la Econometría es que una relación estadística no implica necesariamente una relación causal. Observar que las empresas con mayor liquidez presentan un ROA más elevado no demuestra, por sí solo, que la liquidez sea la causa de dicha rentabilidad. El análisis econométrico proporciona herramientas para aproximarnos a la causalidad, pero siempre requiere apoyarse en la teoría económica y en un diseño adecuado de la investigación.
1.2 Fases del método econométrico y componentes
La Econometría no consiste únicamente en aplicar técnicas estadísticas mediante un programa informático. En realidad, constituye un proceso de investigación estructurado cuyo objetivo es responder preguntas económicas utilizando datos. Aunque los problemas que aborda la Econometría pueden ser muy diversos, todos ellos siguen una secuencia lógica de etapas que comienza con la formulación de una hipótesis y finaliza con la obtención de conclusiones útiles para la toma de decisiones.
La Figura 1.1 resume las principales fases del método econométrico.
- Planteamiento del problema: Toda investigación econométrica comienza con una pregunta cuya respuesta resulta de interés para un investigador, una empresa o un responsable de la toma de decisiones. Algunos ejemplos habituales son:
¿Qué factores explican la rentabilidad económica de las empresas?
¿Influye el endeudamiento sobre el riesgo financiero?
¿Cómo afectan las variaciones de los tipos de interés al mercado bursátil?
¿Qué características aumentan la probabilidad de insolvencia de una empresa?
- Especificación del modelo: Una vez definida la pregunta de investigación, el siguiente paso consiste en construir un modelo que represente las relaciones que se desean analizar. La especificación implica decidir:
cuál será la variable que queremos explicar
qué variables consideramos relevantes para explicarla;
qué forma funcional tendrá la relación entre ellas.
- Obtención de los datos: Una vez especificado el modelo es necesario obtener información sobre las variables que intervienen en él. El modelo econométrico depende en gran medida de la calidad de los datos utilizados. Por ello resulta imprescindible comprobar que:
- las variables están correctamente definidas;
- no existen errores de registro;
- los datos corresponden al fenómeno que se desea estudiar;
- el tamaño de la muestra es suficiente.
- Estimación: Una vez disponible la información, el siguiente paso consiste en estimar los parámetros desconocidos del modelo. Los coeficientes \(\beta_0,\;\beta_1,\;\beta_2\) son desconocidos. La estimación consiste en obtener valores numéricos para dichos parámetros utilizando la información contenida en la muestra. En los próximos capítulos estudiaremos el método de Mínimos Cuadrados Ordinarios (MCO), que constituye la técnica de estimación más utilizada en los modelos de regresión lineal.
Validación del modelo: Una vez estimado el modelo, debemos comprobar si los resultados obtenidos son fiables. La validación pretende responder preguntas como las siguientes:
¿Los coeficientes estimados son estadísticamente significativos?
¿Los signos obtenidos son coherentes con la teoría financiera?
¿Se cumplen los supuestos del modelo?
¿Existen observaciones atípicas que puedan alterar los resultados?
Responder a estas cuestiones constituye una parte esencial del análisis econométrico. Un modelo mal especificado puede conducir a conclusiones erróneas y, en consecuencia, a decisiones empresariales inadecuadas.
- Explotación del modelo: La última etapa consiste en interpretar los resultados obtenidos y utilizarlos para apoyar la toma de decisiones. La Econometría no finaliza con la obtención de una ecuación, sino con la capacidad de interpretar correctamente sus resultados y utilizarlos para obtener predicciones y fundamentar decisiones.
Componentes de un modelo econométrico
Todos los modelos econométricos, independientemente de su complejidad, están formados por cuatro elementos básicos: variables, parámetros, perturbación aleatoria y ecuaciones. Comprender el papel que desempeña cada uno de ellos facilitará el estudio de los capítulos posteriores.
Las variables representan las características que pueden observarse y medirse. En nuestro modelo distinguiremos dos tipos.
Variable dependiente (explicada o endógena): Es la variable cuyo comportamiento deseamos explicar.
Variables independientes (explicativas o exógenas): Son las variables utilizadas para explicar la variable dependiente.
- La perturbación aleatoria, representada mediante (\(u_i\)), recoge todos aquellos factores que afectan a la variable dependiente y que no aparecen explícitamente en el modelo. Se considera tambien una variable de tipo no observable. Las variables explicativas se consideran deterministas (fijas), mientras que la variable explicada se considera aleatoria ya que depende de la perturbación que tiene caracter aleatorio.
- Los parámetros representan los efectos que las variables explicativas ejercen sobre la variable dependiente. Su valor es desconocido y deberá estimarse utilizando la información de la muestra.
- La ecuación econométrica: Finalmente, todas las relaciones entre variables se expresan mediante una o varias ecuaciones. En este libro trabajaremos inicialmente con modelos de regresión lineal de una única ecuación, aunque existen modelos más complejos con más de una ecuación.
1.3 Naturaleza de la información utilizada en Econometría
Los modelos econométricos se construyen a partir de datos. La calidad de las conclusiones obtenidas dependerá, en gran medida, de la calidad de la información disponible y del tipo de datos utilizados. En la práctica, los economistas, analistas financieros y contables trabajan con bases de datos muy diversas. Antes de seleccionar una técnica econométrica es necesario identificar correctamente la naturaleza de la información disponible, ya que no todos los métodos son adecuados para todos los tipos de datos.
En este libro distinguiremos tres grandes tipos de datos:
- Los datos de corte transversal (cross-sectional data) recogen información correspondiente a varias unidades de observación en un mismo instante del tiempo. Las unidades de observación pueden ser empresas, personas, bancos, municipios, países o cualquier otro conjunto de individuos sobre los que se dispone de información. En el ámbito de la Contabilidad y las Finanzas Empresariales, este tipo de datos es muy frecuente.
- Las series temporales (time series) están formadas por observaciones correspondientes a una misma variable recogidas a lo largo del tiempo. En este caso, el interés no reside en comparar distintas empresas, sino en estudiar cómo evoluciona una variable conforme transcurren los meses, trimestres o años. Las series temporales desempeñan un papel fundamental en Finanzas, ya que gran parte de las variables financieras presentan una evolución dinámica. Entre las más habituales se encuentran: precios de acciones;índices bursátiles; tipos de interés; inflación; tipos de cambio; rendimientos de bonos y volatilidad de los mercados.
En este tipo de datos el orden cronológico resulta esencial. Cambiar el orden de las observaciones altera completamente el significado de los datos. Las observaciones no son independientes entre sí, ya que el comportamiento de una variable en un determinado periodo suele estar relacionado con su evolución en periodos anteriores. Esta característica hace necesario utilizar técnicas econométricas específicas que estudiaremos en los últimos capítulos del libro.
- Los datos de panel o datos longitudinales combinan las características de los datos de corte transversal y de las series temporales. En ellos se observa simultáneamente un conjunto de unidades y su evolución a lo largo del tiempo. Por ejemplo, podríamos disponer de información correspondiente a las mismas 100 empresas durante los ejercicios comprendidos entre 2020 y 2024. Cada empresa aparecería varias veces en la base de datos, una por cada año observado.
La Tabla 1.3 muestra un ejemplo simplificado.
| Empresa | Año | ROA | Endeudamiento | Liquidez |
|---|---|---|---|---|
| A | 2020 | 6.80 | 0.45 | 1.65 |
| A | 2021 | 7.20 | 0.44 | 1.71 |
| A | 2022 | 8.10 | 0.42 | 1.76 |
| B | 2020 | 4.90 | 0.70 | 1.10 |
| B | 2021 | 5.30 | 0.68 | 1.18 |
| B | 2022 | 5.80 | 0.65 | 1.26 |
Los datos de panel permiten estudiar simultáneamente las diferencias entre empresas y su evolución temporal. Gracias a ello es posible analizar cuestiones como:
- la persistencia de la rentabilidad empresarial;
- la evolución del endeudamiento;
- el efecto de determinadas políticas financieras a lo largo del tiempo;
- el impacto de acontecimientos económicos sobre diferentes empresas.
Debido a la riqueza de la información disponible, los datos de panel ocupan actualmente un lugar destacado en la investigación en Finanzas y Contabilidad aunque no serán objeto de análisis en este manual.
Variables cuantitativas y cualitativas
Hasta ahora hemos trabajado únicamente con variables numéricas, como el ROA o el endeudamiento. Sin embargo, muchas características relevantes en un análisis económico son de naturaleza cualitativa.
Algunos ejemplos son:
- sector de actividad;
- forma jurídica;
- empresa cotizada o no cotizada;
- existencia de auditoría externa;
- pertenencia a un grupo empresarial;
- provincia o comunidad autónoma.
Aunque estas variables no representan cantidades numéricas, también pueden incorporarse a un modelo econométrico mediante técnicas en las que profundizaremos en el tema 3.
1.4 Practicas resueltas
Top 100 empresas andaluzas del transporte. Importancia del análisis descriptivo previo.
NotaBase de datos 1: Top 100 empresas andaluzas del transporte
Código
datos <- read_excel("data/BD_SABI.xlsx", sheet = "Datos")Podemos ver las primeras observaciones:
Código
head(datos)# A tibble: 6 × 9
ROA LIQUIDEZ_INMEDIATA LIQUIDEZ_GENERAL ENDEUDAMIENTO EBIT VENTAS ACTIVOS
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 4.12 0.11 1.01 63.8 3984. 151205. 96688.
2 1.60 0.037 1.19 79.3 829. 139602. 51679.
3 4.65 0.042 1.36 64.7 4230. 124285. 91036.
4 10.8 2.06 3.81 11.9 7475. 80433. 69025.
5 4.92 0.028 0.789 81.2 1540. 36160. 31330.
6 11.1 0.693 3.24 41.2 3136. 40614. 28131.
# ℹ 2 more variables: EMPLEADOS <dbl>, PROVINCIA <chr>Seleccionamos las variables de interés:
Código
datos_modelo <- datos %>%
  select(ROA, ENDEUDAMIENTO, LIQUIDEZ_INMEDIATA)
Podemos obtener los principales estadísticos descriptivos a partir de la función summary, y la desviación típica con la función sd:
Código
summary(datos_modelo) ROA ENDEUDAMIENTO LIQUIDEZ_INMEDIATA
Min. :-11.781 Min. : 5.944 Min. :0.0000
1st Qu.: 4.043 1st Qu.: 52.103 1st Qu.:0.0305
Median : 6.432 Median : 65.847 Median :0.1390
Mean : 7.685 Mean : 63.798 Mean :0.3471
3rd Qu.: 11.187 3rd Qu.: 81.788 3rd Qu.:0.4005
Max. : 31.760 Max. :102.082 Max. :2.4770 Código
sd(datos_modelo$ROA)[1] 6.778986Código
sd(datos_modelo$ENDEUDAMIENTO)[1] 23.38335Código
sd(datos_modelo$LIQUIDEZ_INMEDIATA)[1] 0.516616La matriz de correlaciones se obtiene con la función cor:
Código
correlaciones <- cor(
datos_modelo,
use = "complete.obs"
)
round(correlaciones, 3)
ROA ENDEUDAMIENTO LIQUIDEZ_INMEDIATA
ROA 1.000 -0.508 0.354
ENDEUDAMIENTO -0.508 1.000 -0.720
LIQUIDEZ_INMEDIATA 0.354 -0.720 1.000Por último los gráficos de dispersión, de la variable explicada con cada una de las variables explicativas, se obtienen con la función ggplot:
Código
# ROA vs Endeudamiento
ggplot(datos_modelo,
       aes(x = ENDEUDAMIENTO,
           y = ROA)) +
  geom_point(size = 2, colour = "steelblue") +
  geom_smooth(method = "lm",
              se = FALSE,
              colour = "red") +
  labs(
    x = "Endeudamiento",
    y = "ROA",
    title = "ROA frente al Endeudamiento"
  ) +
  theme_minimal()
`geom_smooth()` using formula = 'y ~ x'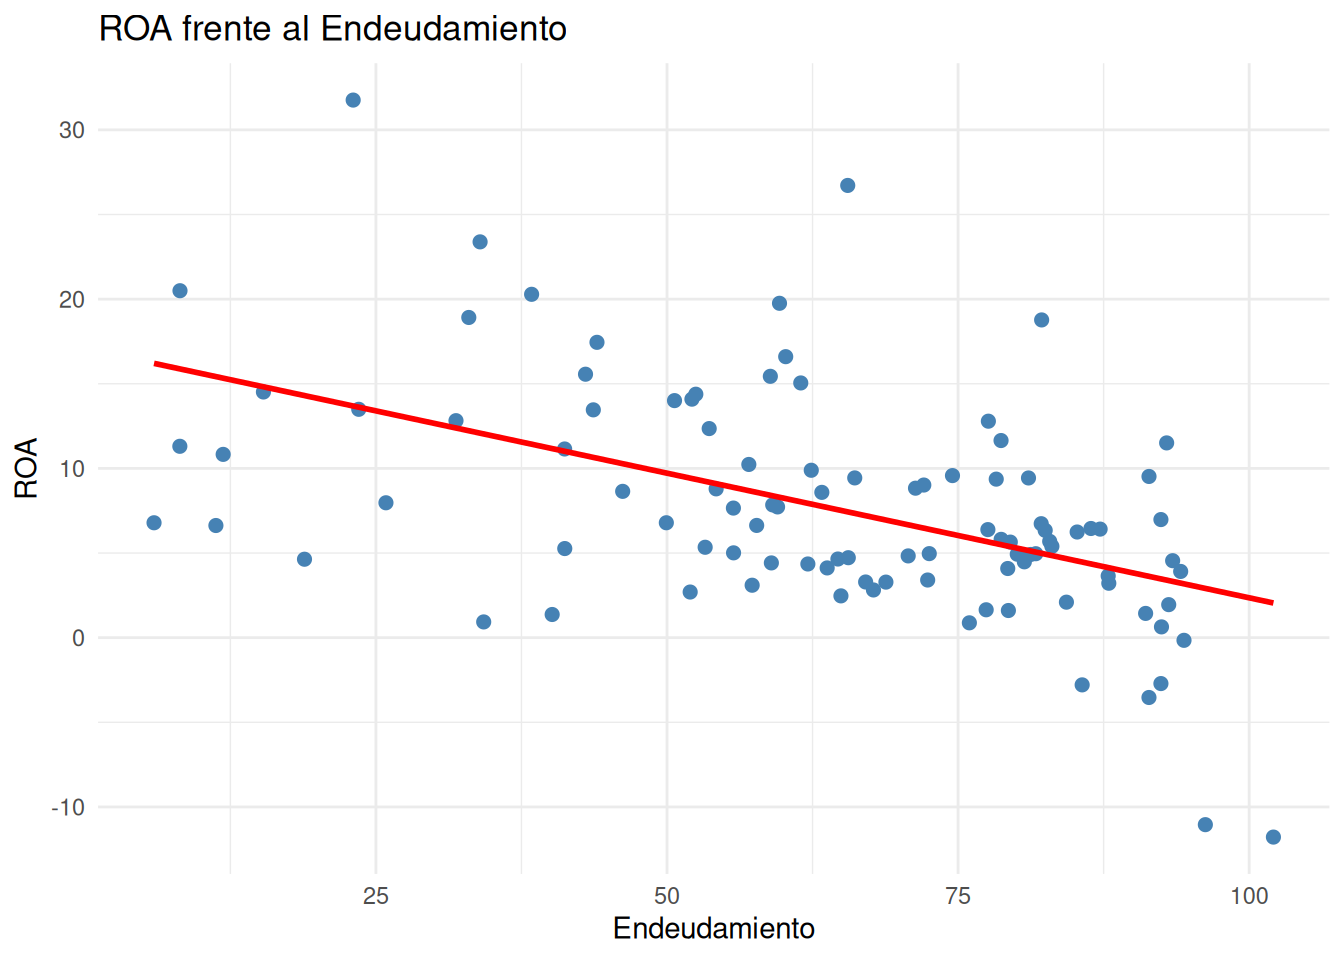
Código
# ROA vs Liquidez
ggplot(datos_modelo,
       aes(x = LIQUIDEZ_INMEDIATA,
           y = ROA)) +
  geom_point(size = 2, colour = "steelblue") +
  geom_smooth(method = "lm",
              se = FALSE,
              colour = "red") +
  labs(
    x = "Liquidez",
    y = "ROA",
    title = "ROA frente a la Liquidez"
  ) +
  theme_minimal()
`geom_smooth()` using formula = 'y ~ x'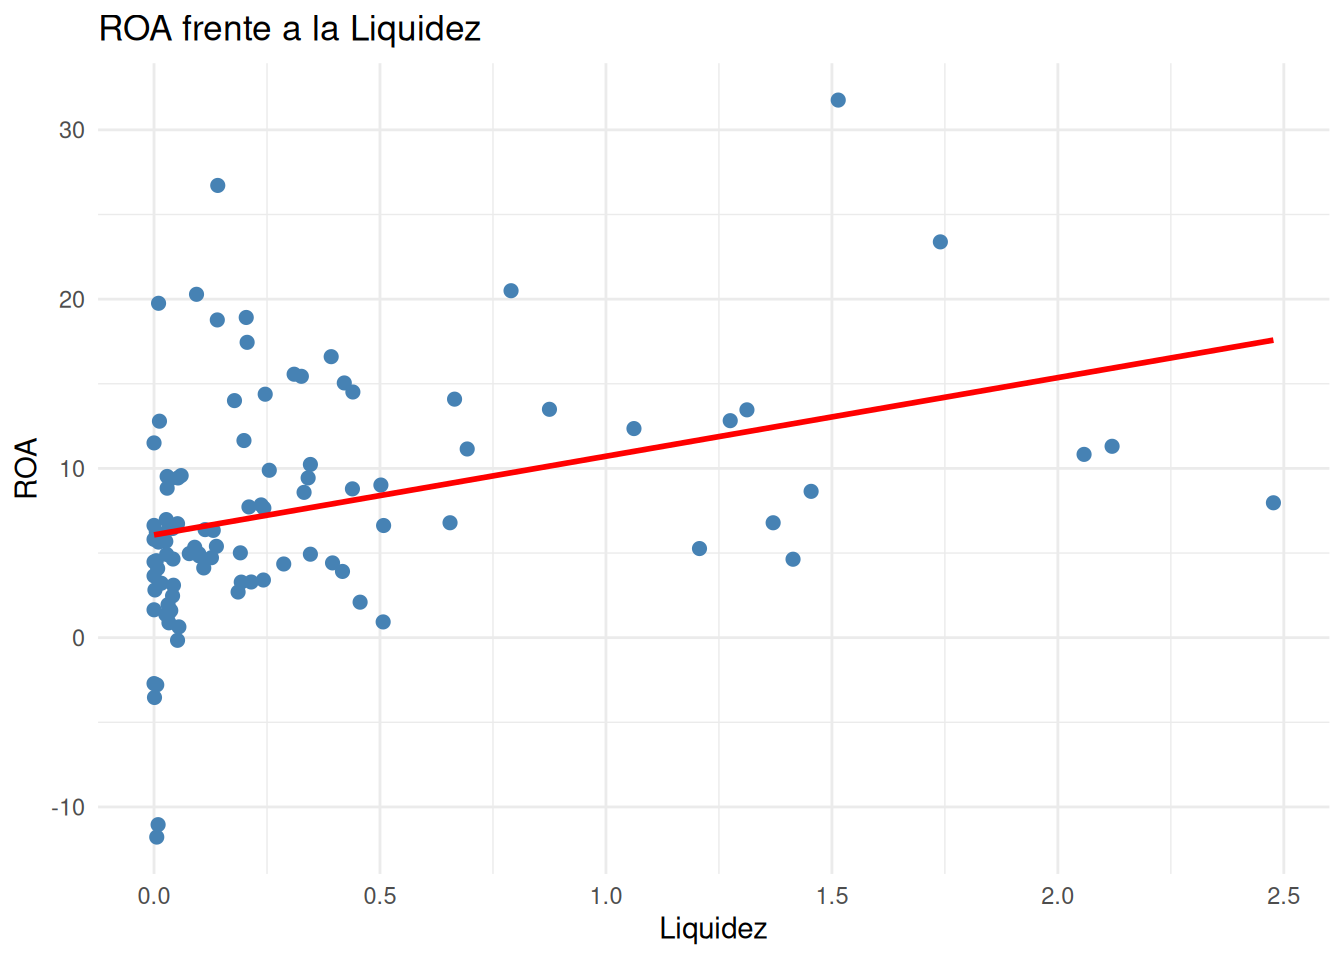
1.5 Practicas propuestas
Realizar el análisis descriptivo previo para la base de datos
IBEX35incluyendo estadísticos descriptivos básicos, la matriz de correlación y los gráficos de dispersión.Para cada una de las siguientes situaciones indique:
- la unidad de observación;
- el tipo de datos;
- una posible variable dependiente;
- dos posibles variables explicativas.
Análisis de 150 empresas españolas durante el ejercicio 2024.
Evolución mensual del precio de una acción entre 2015 y 2024.
Información de 80 empresas observadas entre 2019 y 2024.
Explique con sus propias palabras la diferencia entre un modelo económico y un modelo econométrico. ¿Por qué resulta necesario incorporar una perturbación aleatoria?
Piense en otra aplicación de la Econometría relacionada con las Finanzas o la Contabilidad distinta de las presentadas en el capítulo. Identifique:
- la pregunta de investigación;
- la variable dependiente;
- dos variables explicativas;
- posibles factores que formarían parte de la perturbación aleatoria.
- ¿Por qué es importante distinguir entre datos transversales, series temporales y datos de panel antes de elegir un método econométrico? Razone su respuesta.